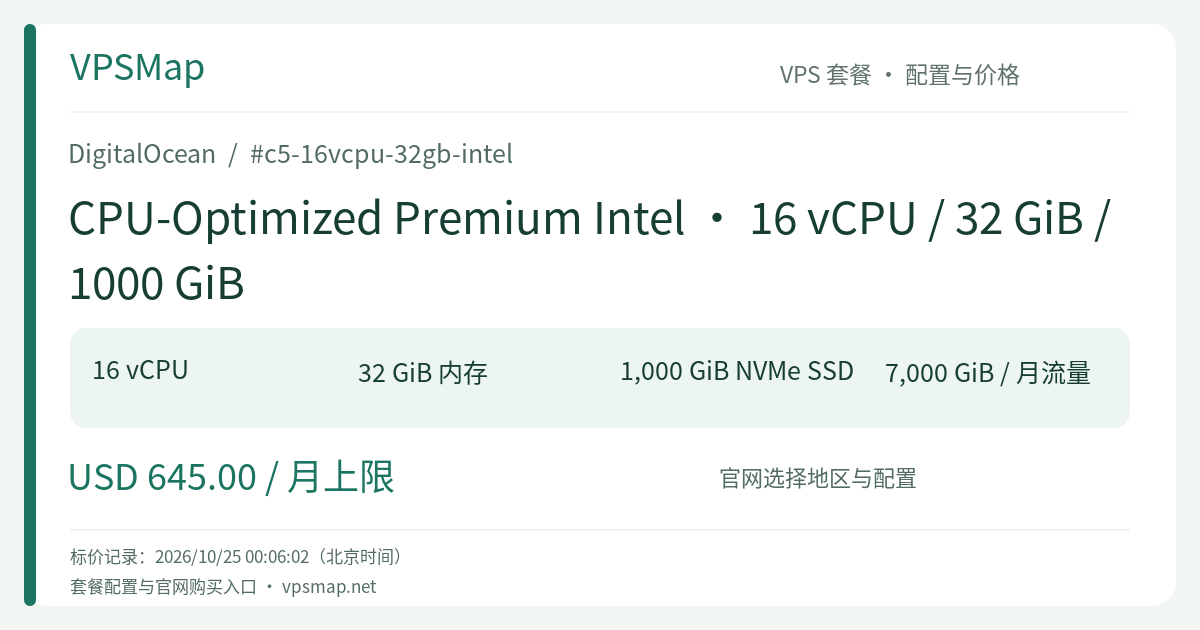
DigitalOcean c5-16vcpu-32gb-intel 深度解析:1 TB 直连 NVMe 打造的本地重度 I/O 算力怪兽
内容更新
为什么 1 TB 直连 NVMe 是计算密集型任务的杀手锏?#
很多开发者在搭建高负载计算服务器时都会遇到一个难题:当计算流水线需要频繁读取或生成数百 GiB 甚至上 TB 的中间数据时,网络挂载块存储(Block Storage Volumes)的吞吐上限和延迟开销会成为严重的拖累。即使为实例配备了 16 个高频独享核心,CPU 也常常因为等待磁盘 I/O 完成而处于闲置卡顿状态。
c5-16vcpu-32gb-intel 是 DigitalOcean 5X 存储配置下的旗舰型号。它将 16 个独享 Premium Intel 超线程、32 GiB 内存 与高达 1,000 GiB(1 TB)的宿主机直连 NVMe 固态硬盘融为一体。1 TB 的本地极速存储消除了网络存储协议的瓶颈,让 16 个核心能够以满负荷极限速度持续运转。
架构优势与硬核性能解析#
1. 宿主机总线直连:1 TB NVMe 的吞吐暴力#
普通云服务器若想获得 1 TB 存储空间,通常需要购买挂载式的云硬盘卷。但网络挂载卷经过了虚拟化网络路由,在应对巨量随机读写(4K 随机 IOPS)时无法比拟直连硬件。c5-16vcpu-32gb-intel 的 1,000 GiB 存储空间直接安装在超线程所在的宿主机上:
- 极速盘内读写:无论是大型 SQLite 索引构建、解压上百个巨大的 tarball 压缩包,还是进行大规模数据清洗转换,读写速率都能达到宿主机 PCIe NVMe 的最高标准。
- 彻底消除 I/O Wait 瓶颈:16 个专用核心同时开工,磁盘响应时间依旧保持在亚毫秒级别,让 CPU 利用率维持在健康高效的高位。
2. 16 个独享 Intel Xeon 核心:零争抢、零衰减#
该机型基于第 3 代 Intel Xeon Scalable 处理器(基础频率高于 2.6 GHz),每个 vCPU 对应一个物理超线程的独占使用权。与共享型实例不同,无论宿主机上的其他租户如何施压,你的应用都能稳定获取全部 16 核算力,避免因邻居干扰造成的批处理任务超时。
3. 10 Gbps 增强型网络与 7,000 GiB 流量#
Premium 系列的物理网卡配备 10 Gbps 吞吐能力,数据导出速率相比常规实例提升至 5 倍。套餐内还附带了 7,000 GiB 团队月度免费公网出方向流量池(入方向完全免费),并且同可用区内通过 VPC 私网与其它 Droplet 通信不计入公网流量,非常适合作为分布式架构中的主力计算或处理节点。
适合哪些核心业务?#
- 超大型单体工程/Monorepo 并发构建:管理 Chromium、Android AOSP、大型游戏引擎或复杂微服务 Monorepo 代码库,本地源码与生成文件轻松突破数百 GiB,需要 1 TB 极速空间与 16 核并发才能在合理时间内完成构建与测试。
- 离线大数据 ETL 与分析处理:运行 Apache Spark(单节点 Standalone 模式)、ClickHouse 或 DuckDB 处理数百 GiB 本地数据文件,进行高效的批处理过滤与聚合。
- 连续视频批量切片与离线转码库:本地暂存上百部 4K 原始成片素材,完成 H.265/AV1 高强度压缩与多分辨率 HLS 切片分发,避免网络卷频繁拉取数据的等待。
- 模型推理中间数据缓存与预处理:在运行基于 CPU 的大规模文本提取、向量化计算或特征工程时,保存大体积语料与中间索引。
成本管理与生产实践#
- 按秒计费与 672 小时月封顶:该机型执行标准的 DigitalOcean 封顶计费规则,每月计费最高为 672 小时。即使只在特定项目攻坚期运行数天,也能享受到精确到秒的高端算力支持。
- 停机成本考量:由于该机型独占锁定 16 个专属 CPU 核心与 1,000 GiB 宝贵的本地 NVMe 硬件,在控制台停机(Power Off)依然会正常计费。若流水线只需周期性运行(如仅在周末跑批量任务),建议在作业完成后制作自定义镜像(Snapshot)并彻底销毁(Destroy)Droplet。
- 备份策略:由于本地磁盘容量高达 1 TB,首次备份为全量备份,后续为增量备份。开启官方备份服务后,每周备份增加 20% 费用(保留 4 周),每日备份增加 30% 费用(保留 7 天)。也可结合自身的冷存储方案(如 rsync 定期推送至 Spaces 对象存储)建立多层保护。
选型总结#
c5-16vcpu-32gb-intel 是一台专为“吞吐饥渴型”场景打造的计算型重器。如果你的 16 核流水线正在被几十或几百 GiB 的磁盘上限所困,或者受够了网络存储带来的 I/O 延迟,这款拥有 1 TB 本地直连 NVMe 的实例就是理想的选择。