DigitalOcean 60核240G通用型(Premium Intel · 900G NVMe)选购解析:重载中枢的算力平衡点
内容更新
架构定位:旗舰算力与标准存储的协同#
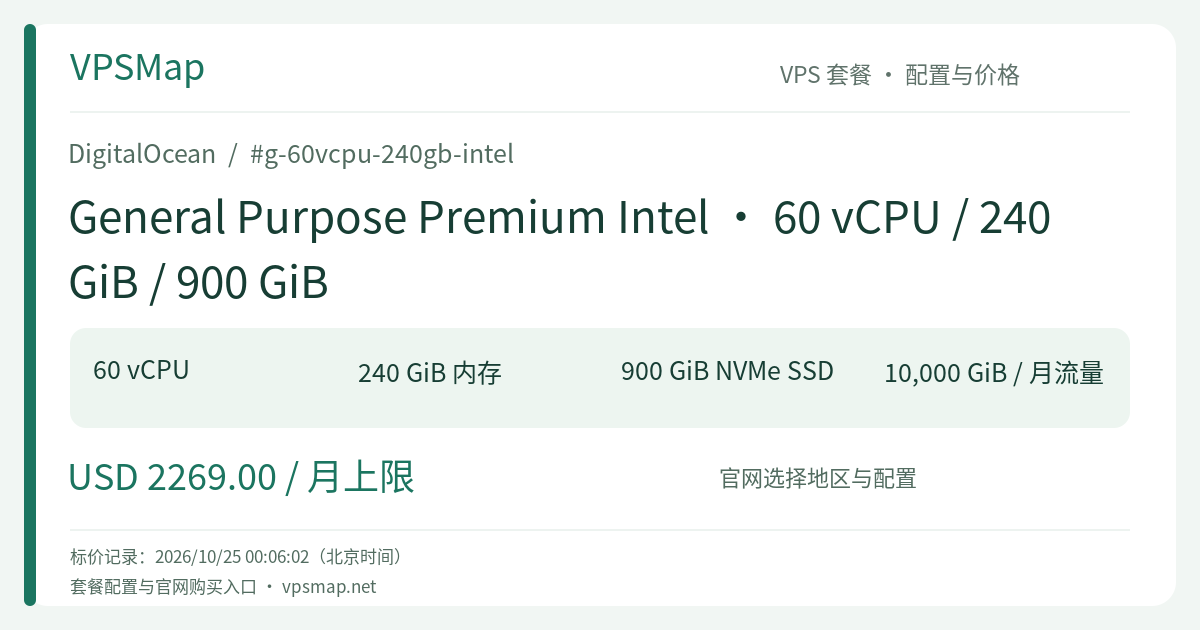
在构建企业级核心服务或承载持续高并发业务时,架构师最常面临的挑战不是硬件资源的堆砌,而是算力、内存与存储吞吐之间的平衡配置。DigitalOcean 的 g-60vcpu-240gb-intel 属于 General Purpose(通用型)Premium Intel 序列中的顶格机型之一,其核心逻辑在于为需要高确定性算力、充沛内存、但存储依赖解耦架构的系统提供坚实底座。
该机型配备了 60 颗专属 vCPU,基于第三代 Intel Xeon Scalable(Ice Lake 架构)处理器构建,并配置了 240 GiB 物理内存。相比共享型 CPU(Shared CPU)可能因宿主机邻居争抢而出现的周期性性能波动,专属 CPU 实例(Dedicated CPU)确保每一个虚拟核心独占物理超线程,算力供给平稳连续。结合约 4:1 的经典内存/核心黄金配比,这套机型能够从容应对并发连接池激增、JVM 堆内存扩展或复杂业务逻辑的高并发计算场景。
配备的 900 GiB 本地固态硬盘直接采用 NVMe 协议接入物理宿主机。与传统 SATA 接口甚至基于网络的云硬盘相比,直连 NVMe 拥有极高的并发通道与极低的 I/O 延迟。900 GiB 的容量对于操作系统、中间件环境、热运行时工作区以及适度的本地事务缓存而言恰到好处,既避免了为过剩的本地硬盘支付闲置成本,又保证了系统核心调用路径上的极致读写表现。
适用场景:它能解决哪些具体业务痛点?#
1. 存储解耦型的大型企业应用与微服务中枢#
在现代化云原生架构中,应用层往往与状态持久层进行物理分离。如果你的微服务集群、大型单体应用(如大型 ERP、CRM 后台)或 API 网关自身承载成千上万个活跃会话,需要大量 CPU 核心处理加解密、序列化和业务编排,而持久化数据统一托管于独立的高可用数据库集群或云对象存储(如 DigitalOcean Spaces),那么本款机型正是理想之选。240 GiB 的大内存为各类应用运行时提供了极为充裕的缓冲空间,无需频繁进行 GC(垃圾回收)甚至触发 OOM 停机。
2. 高通量 Kubernetes 工作节点(DOKS Worker Node)#
作为 DigitalOcean Kubernetes (DOKS) 集群的高性能工作节点,单台 60 核 240 GiB 的庞大规格可以显著降低集群内部跨节点通信的开销。你可以将大量紧密协作的 Pod 调度并锁定在同一台宿主机内,借由 Linux 本地进程间通信与内部虚拟网桥完成极速数据交换。900 GiB 本地 NVMe 磁盘足以承载节点镜像缓存、容器生命周期日志以及短暂的临时卷(emptyDir)。
3. 高吞吐量流式代理与出海流量枢纽#
Premium Intel 系列的一大关键技术红利是具备高达 10 Gbps 的网络突发与传输带宽,这一传输能力是常规 CPU 机型的 5 倍。当你需要快速导出分析数据、搭建跨区域反向代理网关、或为下游数千个客户端实时转发多媒体与业务流时,10 Gbps 上行链路能够杜绝网络接口成为整体吞吐的物理瓶颈。
计费逻辑与成本把控机制#
理解 DigitalOcean 的计费机制能够帮助企业更精准地规划基础设施支出:
- 秒级计费与 672 小时封顶(28 天上限):本款实例按秒计费(单次启动最低计费 60 秒或 $0.01),每个账单周期内最多累计计费 672 小时。即使月份包含 30 或 31 天,超出 672 小时后的运行时长不再额外扣取基础实例费,极大降低了长期连续运行业务的预算波动风险。
- 关机计费规则(Power Off vs Destroy):由于专属计算资源(专用 CPU 超线程、独占物理内存与 NVMe 宿主槽位)在关机状态下依然在宿主机被锁定保留,单纯在操作系统内关机或控制台执行 Power Off 仍会持续产生账单。若需彻底停止计费,必须在控制台或通过 API 销毁(Destroy)该 Droplet。
- 团队级带宽池化机制:该配置自带 10,000 GiB(约 10 TB)的免费公网出站流量。这部分配额会自动汇入团队全局带宽池(Team Bandwidth Pool),按照在线秒数线性累积。只要团队内所有实例的公网出站总和未超过总额度,单个实例偶发超出 10,000 GiB 也不会产生追加费用。若超出整个团队池,超出部分出站流量按照 $0.01/GiB 计费,入站流量全程免费。
- VPC 内网通信免费:同一区域内通过 VPC 私有网络接口进行的实例互联,不计入公网流量池,这为大规模集群构建内部通讯网络提供了零成本通道。
关键取舍与横向选型建议#
在决定采购 g-60vcpu-240gb-intel 之前,需要结合团队整体技术栈进行必要的取舍考量:
| 对比维度 | g-60vcpu-240gb-intel (900G) | 同系高配 gd-60vcpu-240gb-intel (1800G) | 存储优化型 (Storage-Optimized) |
|---|---|---|---|
| 核心优势 | 算力与内存顶配,基础总拥有成本(TCO)更精简 | 本地 NVMe 翻倍至 1.8 TB,溢价幅度低 | 每核搭配高达 150G-225G NVMe,专注海量数据检索 |
| 适用场景 | 存储解耦应用、微服务、Kubernetes 汇聚节点 | 自建大型数据库、重载 ElasticSearch 节点 | 密集写入型时序库、大型 NoSQL 存储仓库 |
| 存储拓展性 | 依赖挂载 Volumes 块存储或 Spaces 对象存储 | 本地空间充沛,亦可叠加云存储 | 主打本地磁盘高 IOPS,网络依赖度低 |
[!NOTE] 容量与可用性提示:数据中心的高配物理宿主机资源受上架批次影响,控制台展示的标称价格属于官方目录标准价。由于企业级 60 核实例需要特定的双路物理节点支撑,建议在正式迁移业务前,通过控制台或 API 先行在目标可用区尝试发起交付验证,确保该可用区有充足物理余量支持随时扩容。
若你的系统架构已经实现了计算与存储的分离,或业务本身对本地长期大容量落盘需求有限,选择这款 900 GiB NVMe 的标准配置,可以在不浪费任何存储预算的前提下,榨干 60 颗专属 Xeon 核心与 240 GiB 内存的每一点生产力。