双倍本地 NVMe 的吞吐红利:DigitalOcean 32核 128G 960G 存储增强型深度选型
内容更新
在重载业务系统里,存储往往是最容易被低估的系统瓶颈。许多团队在选配高性能云主机时,往往只关注 CPU 主频和内存大小,却忽视了一个关键细节:网络挂载块存储(Block Storage)无论如何优化,在毫秒级寻道和微秒级 WAL 刷盘表现上,永远无法比拟直接挂在宿主机 PCIe 通道上的物理 NVMe。
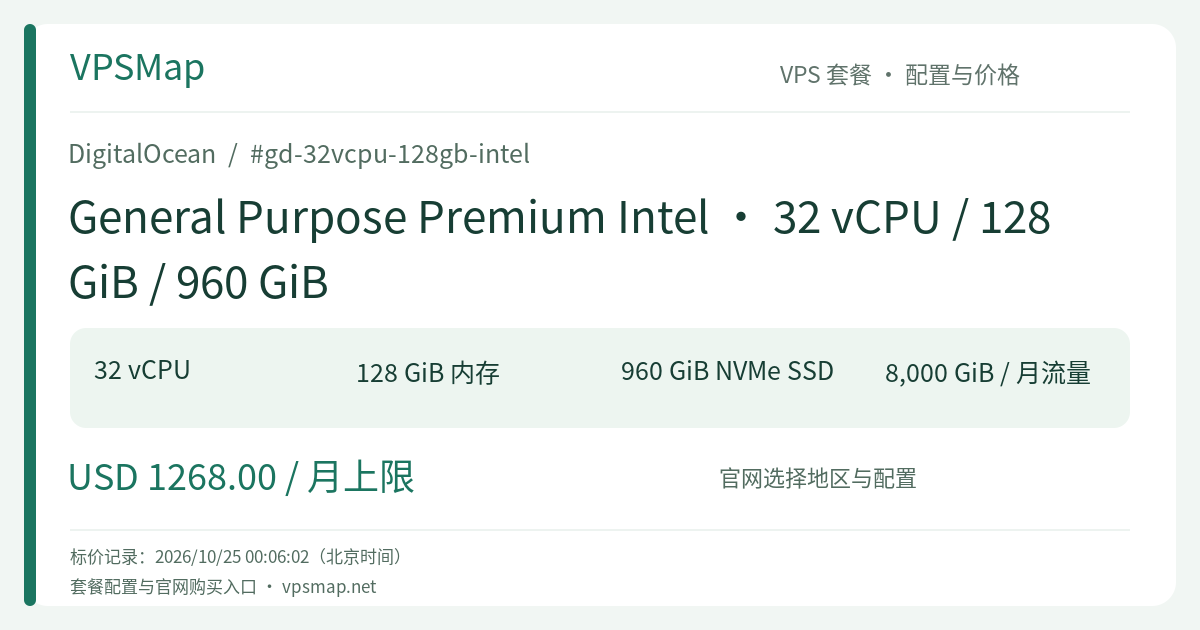
DigitalOcean 的 General Purpose Premium Intel 32 vCPU / 128 GiB / 960 GiB(型号标识 gd-32vcpu-128gb-intel),正是为了解决“既要大算力、大内存,又要海量极速本地直连存储”的严苛场景而诞生。
为什么 960 GiB 直连 NVMe 是核心数据库的甜蜜点?#
对比基础版 g-32vcpu-128gb-intel 的 480 GiB 磁盘,gd- 版本直接将本地 NVMe 容量翻倍至 960 GiB。这一提升对很多数据库架构师来说意义非凡:
- 容纳数百 GB 级单机高吞吐主库:现代生产级 PostgreSQL 或 MySQL 集群在包含历史表、索引和归档日志时,数据体积常年落在 300GB–700GB 区间。480 GiB 往往捉襟见肘,而 960 GiB 恰到好处地留出了 30% 以上的安全水位线。
- 规避网络存储的网络开销与抖动:网络块存储(Volumes)受限于虚拟机与存储集群间的网络协议封装,遇到写入爆发时极易产生 I/O 排队。而直连 NVMe 依托底层硬件的并行通道,能够轻松承载数万 IOPS 的瞬时突发,将事务提交(fsync)耗时压制在亚毫秒级。
- 极致的搜索与分析吞吐:如果你在搭建 Elasticsearch、OpenSearch 或 ClickHouse 节点,960 GiB 的 NVMe 能够直接充当高频热分片(Hot Tier)的落盘介质,大幅缩短复杂倒排索引与聚合查询的响应延迟。
算力与内存基石:32 独享超线程与 128 GiB 黄金组合#
存储的跃升并没有牺牲任何计算与网络特性:
- 第三代 Intel Xeon Scalable 独享算力:32 个专属超线程享有宿主机底层物理核心的绝对保障,杜绝邻居虚拟机的算力抢占,保障并发连接处理与复杂计算时效。
- 128 GiB 充沛内存池:4:1 的内存 CPU 比例是大型企业级系统的黄金配置。你可以放心为数据库分配 64 GiB 以上的高速缓冲池,剩余内存完全足以支撑几十个常驻后台 worker 或高并发连接池,避免任何交换分区(Swap)损耗。
- 最高 10 Gbps 网络传输与 8 TB 流量池:Premium Intel 系列专属的高达 10 Gbps 网络出口能力,使得从该实例进行主从复制、异地灾备导出或大规模日志拉取时,速度比常规实例提升数倍。每月 8,000 GiB 的免费出站流量池自动汇入团队配额,入站完全免费。
成本效益精算:多花极少预算,换取质变级的架构自由度#
从商业定价角度来看,gd-32vcpu-128gb-intel 的定价策略极具诚意:
- 相比 480 GiB 基础版本,月度封顶价格仅增加了几十美元的微小差距。
- 如果在基础版上通过额外挂载等容量的网络存储卷来补齐 480 GiB 空间,综合成本不仅非常接近,还要额外承受网络 I/O 延迟与吞吐上限。
- 因此,只要你的业务在未来半年内有明确的数据增长预期,直接选择 960 GiB 的
gd-版本是更明智、更具前瞻性的架构决策。
生产环境落地指南#
- 计费与生命周期:遵循 DigitalOcean 标准的按秒计费与每月 672 小时封顶策略。关机状态因仍保留专属 CPU 与直连 NVMe 空间,会继续计费;测试完成后若不再使用,请及时 Snapshot 镜像并 Destroy 实例。
- 数据安全防护:直连 NVMe 带来超凡性能的同时,要求团队建立更完备的数据冗余机制。强烈建议开启 DigitalOcean 自动化备份,或利用 VPC 私网搭建跨机房的主从实时复制架构,确保业务数据的高可用性。
对于正在经受 I/O 瓶颈折磨、又不愿向复杂昂贵的裸金属服务器妥协的工程团队,这台 32 核 128G 960G 存储增强型实例,将是让系统性能脱胎换骨的坚固基石。