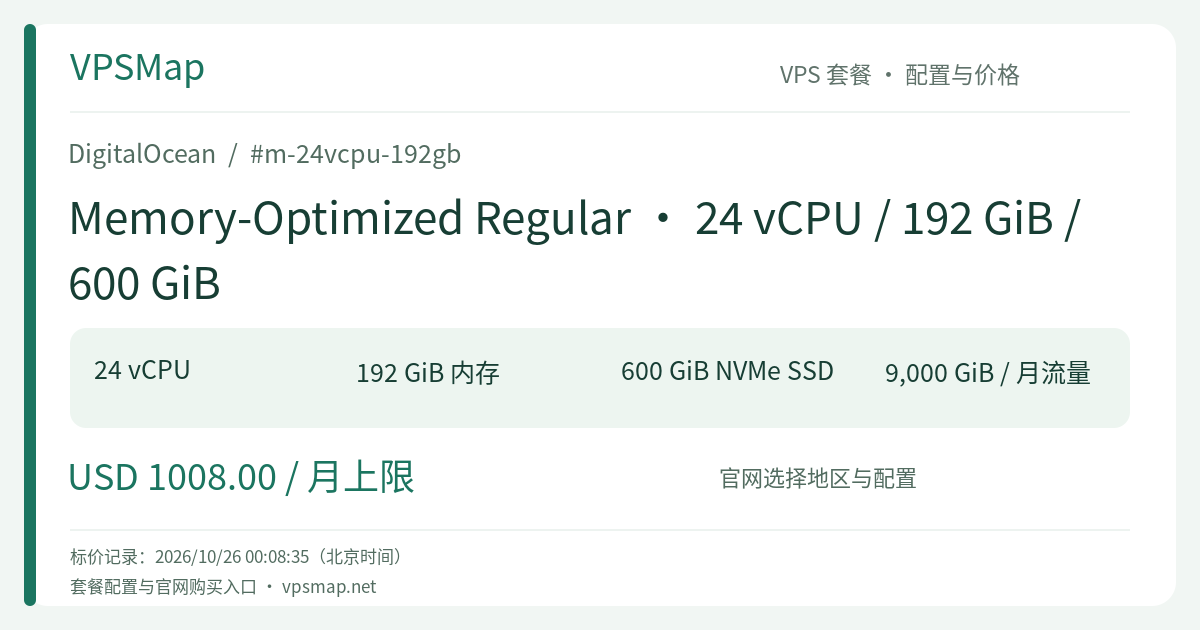
DigitalOcean 24核/192G 内存型实例评测与选型指南 (m-24vcpu-192gb)
内容更新
为什么你需要 192 GiB 内存级别的云主机?#
在很多高并发系统的演进过程中,架构师往往会遇到一个瓶颈:增加 CPU 核心并不能解决响应延迟,因为瓶颈在内存命中率。当你的 Redis/KeyDB 缓存工作集膨胀到上百吉字节、Elasticsearch 堆内存与文件系统缓存(Page Cache)开始频繁争抢,或者核心 PostgreSQL 数据库的热点表无法全部放进 shared_buffers 时,磁盘 I/O 争用就会成为吞吐量的无形杀手。
DigitalOcean 推出的 m-24vcpu-192gb 正是为打破这一瓶颈而设计的专业主力机型。它提供 1:8 的黄金核心内存比(24 颗独享物理超线程与 192 GiB 独立物理内存),让你的核心数据常驻内存,彻底告别 OOM(内存溢出)被系统杀进程的运维噩梦。
核心定位:纯粹的内存吞吐利器#
该配置属于 DigitalOcean 的 Memory-Optimized Regular 家族,其特点是:
- 独享物理超线程(Dedicated vCPU):24 颗专属计算核心,不与邻居租户争夺时钟周期,确保长耗时批处理、大规模哈希计算与并行复杂查询拥有 100% 稳定的基准算力。
- 192 GiB 庞大工作集空间:单机即可支撑 100GB+ 级 Redis 实例、跨服务共享的会话网格,或运行多个堆内存超过 32GB 的 Java/Kotlin 后端微服务。
- 轻巧克制的 600 GiB NVMe 本地盘:在很多大数据架构中,持久化层已经由独立对象存储(如 Spaces)或外挂数据块(Volumes)承担。本地 600 GiB NVMe 专注于支撑操作系统运行与高频 WAL(预写式日志)刷写,不会让你为用不上的多余本地磁盘容量多掏冤枉钱。
最适合运行的业务场景#
- 分布式内存缓存与实时状态库:部署大规模 Redis、Valkey 或 Memcached 集群,支持数以亿计的实时在线用户会话和商品库存计数。
- 大型企业级 Java/JVM 框架整合:将数十个分散部署在小虚机上的微服务收缩合并至单台高配主机,大幅削减跨虚机网络调用开销,并从容分配垃圾回收(GC)缓冲区。
- 分析型查询引擎节点:作为 ClickHouse、Trino/Presto 或 Apache Spark 的计算 Worker 节点,应对海量关联查询(Large Joins)与全量聚合。
- 中大型数据库主力节点:作为高频读写 MySQL/PostgreSQL 生产库,将活跃索引与核心高频表全部载入内存。
计费机制与成本控制优势#
该型号采用 DigitalOcean 标志性的 28天封顶计费(672小时封顶) 机制。按秒计费的颗粒度允许你在月末业务高峰或专项跑批时按需拉起,任务完成后随时销毁(Destroy);而如果是 7x24 小时常驻运行,达到 672 小时后当月后续时间完全不再额外扣费,大幅降低了总拥有成本(TCO)。
此外,该机型享有团队级别的 9,000 GiB 出网流量池,入站流量全程免费,内网(VPC)互联免费。对于多机群协同架构,同一专有网络内的节点通信完全没有网络费用顾虑。
运维选型建议: 24 vCPU / 192 GiB 属于云平台高阶核心算力,不同可用区的物理库存随业务动态变动。在正式上云架构定型前,建议登录控制台确认目标机房的即时容量并预先创建快照模板。