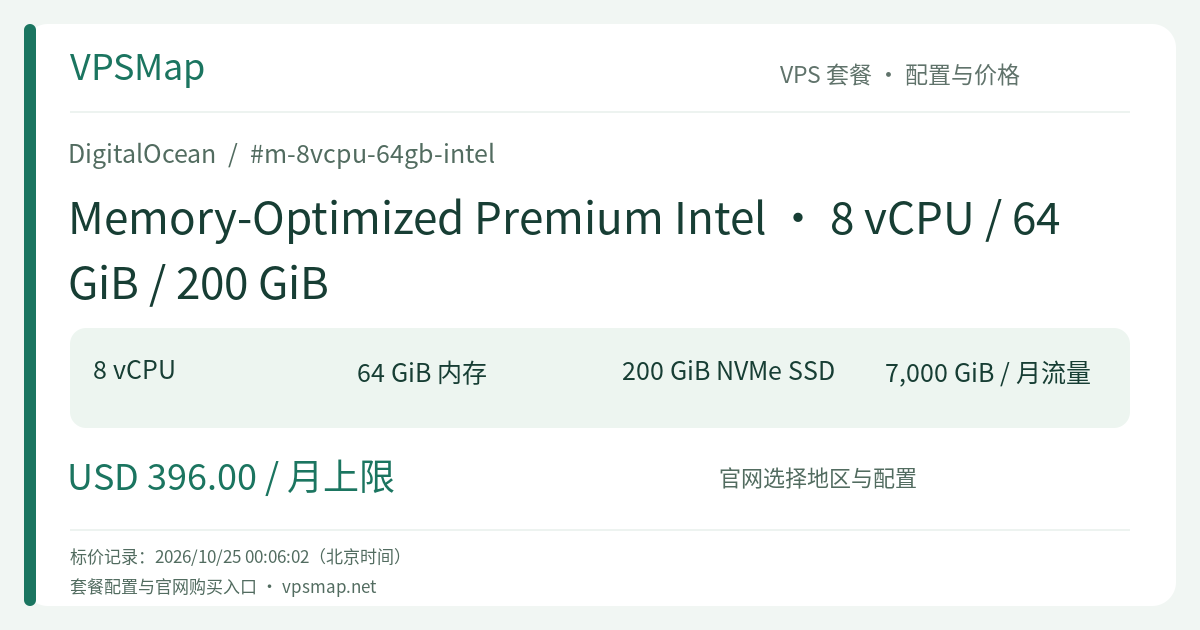
DigitalOcean Memory-Optimized 8 vCPU / 64 GiB (Premium Intel) 测评:高并发关键业务与大规模内存计算的旗舰算力
内容更新
面对海量并发,系统为什么需要 64 GiB 的内存池?#
当系统承载的业务进入企业级规模——例如大型 SaaS 多租户平台、高频金融交易流水网关、或数万活跃长连接的物联网中枢时,服务器面对的压力早已不再是简单的“页面打开快不快”,而是极端突发流量下的系统容灾底线:
- 上万并发连接的内存开销:每个 TCP 连接、SSL/TLS 握手会话及工作线程都占用数 KB 到数十 KB 内存。当数万连接并发涌入时,数 GiB 内存瞬间被连接栈吞没。
- 分布式缓存的巨大容量需求:企业级 Redis 实例如果需要存储千万级对象并维系多副本同步缓冲(Replication Backlog),64 GiB 内存才能彻底避免频繁触发内存淘汰策略(Eviction)。
- 数据密集型 Java / JVM 巨型应用:给 JVM 分配 32 GiB 堆内存后,依然能够剩余 32 GiB 内存给堆外内存(Netty Direct Memory)、RocksDB 嵌入式存储与操作系统磁盘缓存,保障超低 GC 停顿与极致读写表现。
DigitalOcean 这款 Memory-Optimized 8 vCPU / 64 GiB (Premium Intel) 方案,就是专为这种“不能有一丝妥协”的核心系统打造的企业级计算平台。
专属 Premium Intel 的企业级架构指标#
- 8 颗专属 Intel Xeon 可扩展处理器(Ice Lake) 具备 8 颗完全专属的物理超线程,不与任何其他租户共享计算周期。面对多线程并发计算、重度数据序列化与复杂 SQL 解析,始终输出平稳无波动的 CPU 算力。
- 64 GiB 2933 MHz 物理内存 超大内存容量配合 2933 MHz 高频率,让内存数据吞吐带宽大幅提升,充分满足高并发内存数据库与实时流处理引擎(如 Flink / Spark Streaming 单节点)对内存吞吐的严苛要求。
- 10 Gbps 超高带宽网卡 Premium 规格标配高达 10 Gbps 网络通信能力。在跨节点数据同步、海量客户端请求分发或全量数据库快照备份时,能够以极高网络速率快速释放网络队列压力。
- 7,000 GiB 月度免费团队流量池 每月自带 7,000 GiB 免费公网出向流量(入向完全免费),且全部汇入团队流量池。即便面对高并发媒体流或频繁的数据交换,也能从容覆盖,超额流量仅按 $0.01/GiB 结算。
200 GiB 本地 NVMe 的定位与场景契合度#
本款 Droplet 标配 200 GiB 直连 NVMe 固态硬盘:
- 极其适合的架构模型:计算与持久存储解耦的大型架构。例如,该实例主要作为巨型 Redis 缓存层、Kafka Broker(日志存储于外挂存储或定期滚动归档)、或者与 DigitalOcean Spaces 对象存储结合的转码与内存计算节点。
- 何时需要考虑升档:如果这台 8 核 64G 机器要直接承载一个包含数百 GiB 本地历史事务数据的单体主数据库,建议优先考虑其姊妹型号
m3-8vcpu-64gb-intel(拥有 600 GiB 本地 NVMe),每月仅需增加 $44 即可获得高达 3 倍的本地存储空间。
典型核心企业级工作负载#
- 多租户 SaaS 核心后端与微服务中枢: 支撑数百个微服务容器或数十个高并发应用工作进程(Go、Node.js、Java),轻松消化峰值流量带来的连接暴增。
- 高性能内存计算与流处理中枢: 适合运行 Apache Flink、Logstash 或中型 Kafka 消息队列,在 64 GiB 内存中保持超大内存消息缓冲区,消除下游系统消费迟缓带来的背压风险。
- 核心业务只读副本群主控节点: 作为大型生产数据库的只读主力节点,将绝大部分热点索引与近期事务完整吸纳进内存,让复杂的只读分析查询对线上主库零影响。
生产级高可用部署与计费保障#
- 按秒计费与 672 小时封顶:每小时费率约为 $0.58929,每月按 672 小时计算封顶为 $396.00。按秒计费机制允许运维团队在业务大促前临时拉起多台该实例分担压力,大促结束后一键销毁,极大优化总体 IT 拥有成本(TCO)。
- VPC 私有网络全免费互联:在同一个 VPC 内部,多台 Droplet 之间的数据传输完全免费且不占用 7,000 GiB 流量池,充分满足微服务之间密集的内网数据交互。
- 企业级全自动备份:开启 DigitalOcean 增量备份功能后,系统会自动在业务低谷期生成轻量级快照,保障企业核心业务数据的连续性。