
CPU短时冲高时先做什么:区分短峰、持续负载与控制台限额#
登录 VPS 发现 CPU 使用率突然冲高时,不要急着重启实例或花钱升级套餐。第一步应当先确认负载的具体特征:究竟是每隔几分钟出现一次的短暂尖峰,还是应用任务堆积导致的持续繁忙。
根据官方服务条款,搬瓦工非 SLA 套餐将短时 CPU 突发与一小时平均使用额度分开管理,具体的计算周期与额度取决于完整套餐名称。这意味着短时间内把 CPU 跑到 100% 并不等同于触发了超额限制。只有当一小时平均使用量持续超出套餐额度时,底层系统才会限制实例可用的 CPU 周期。在受限期间,实例依然保持运行,KiwiVM 控制面板也会出现提示;当负载回落到允许范围内后,限制会自动解除。官方条款并未承诺限制会在几分钟内或瞬间解除,排查时也不能把单次瞬时满载截图当作触发限额的凭证。
同时要观察你的实际业务。如果网站和 API 接口的响应速度完全正常,页面没有出现超时排队,控制面板中也没有 CPU 限制提示,这类短时尖峰对访客体验的实际影响往往非常有限。
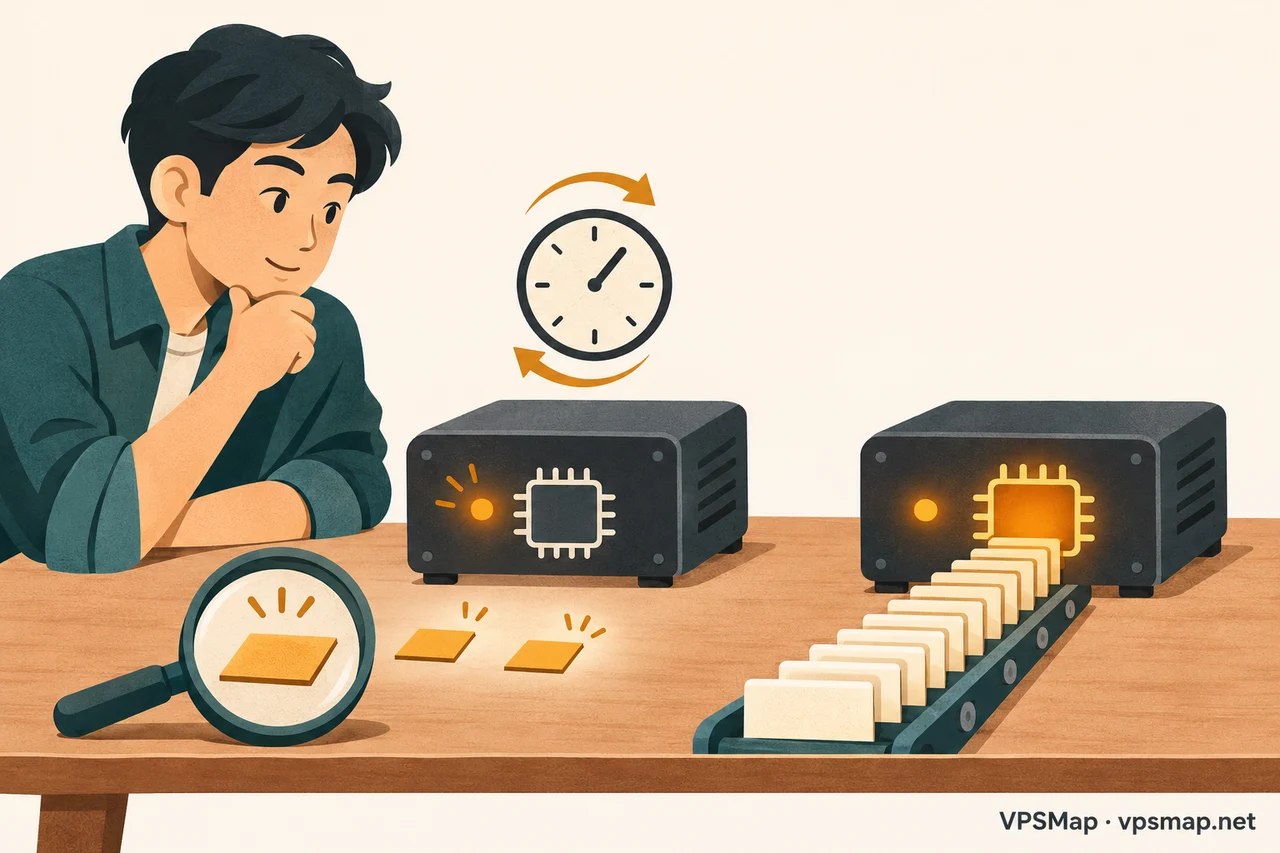
理清这两种状态的核心区别,能帮助你避免不必要的硬件投入:
- 短时重复突发:CPU 偶发或按固定周期冲高数秒,随后迅速回落,系统整体空闲,业务请求处理顺畅。
- 持续过载排队:CPU 长期居高不下,一小时平均消耗触碰套餐上限,面板亮起限额警告,同时伴随页面响应变慢。
用只读命令连续观察与抓取进程 PID#
确认需要排查后,应当先在系统内部进行连续的只读观察,定位到底是什么进程在消耗算力。这里只使用 Linux 自带的基础观察工具,不改动任何系统配置或运行状态。
首先使用 top 进行批处理模式的短窗口观察:
top -b -d 2 -n 6该命令以 2 秒为时间间隔连续采集 6 次,首次输出无需等待 2 秒。通过这种短窗口观察,你可以连续记录 PID、COMMAND、%CPU 以及执行时机。需要注意的是,具有间歇特性的短命进程可能会在两次采样间隔之间启动并结束;某一次输出中没有看到占用,并不能彻底排除其存在。该命令适用于安装了 procps 的常见 Linux 发行版,若系统缺少该工具,请先查阅对应的发行版官方文档。
为了获取当前进程状态的全局快照,可结合 ps 命令查看列表前几行:
ps -eo pid,ppid,comm,pcpu,pmem --sort=-pcpu | head -n 16因为 head -n 16 包含了表头,所以命令会输出当前列表的前几行进程。这里需要特别注意 ps 的统计口径:输出中的 %CPU(即 pcpu)是该进程自启动以来的累计 CPU 时间与已运行总时长的比例,属于生命周期内的平均值。它既不是当前 2 秒内的瞬时实时采样,也不是服务商衡量一小时配额的依据。按 pcpu 排序显示的是生命周期平均占比靠前的进程,而非当下的瞬时峰值。此外,使用 comm 字段只显示可执行文件名而不展开完整命令行参数,能有效减少数据库密码或 API 令牌等敏感信息的暴露,但在分享终端输出时仍需进行人工检查。
当通过观察锁定了具体的目标 PID 后,使用以下两条命令分别核对该进程的已运行秒数与父进程信息:
ps -p PID -o pid,ppid,comm,etimes,pcpu,pmemps -p PARENT_PID -o pid,ppid,comm执行时必须将占位符 PID 与 PARENT_PID 替换为刚才查到的实际数字。由于短命进程随时可能退出,Linux 系统的 PID 也会被后续新进程复用,在运行查询前务必再次确认进程依然存活。仅凭一个命令名无法直接判断软件来源、安全性或是否可以终止,记录下真实的运行时间与父子关系才是进一步分析的基础。
对照系统定时器与排查任务来源#
如果发现进程呈现规律的周期性波动,接下来需要将峰值发生的时间点与系统的调度机制进行比对。
对于采用 systemd 的系统,可以运行以下命令查看定时器状态:
systemctl list-timers --all --no-pager该命令会列出当前已加载到 systemd 内存中的所有定时器(包含处于非活动状态的单元),并显示上次触发时间、下次计划时间以及关联的后台服务。你可以将记录到的 CPU 冲高时间戳与这些定时器的触发规律进行对照。需要明确的是,该命令仅适用于使用 systemd 的环境,且无法覆盖传统 cron 定时任务、容器内部的调度器或应用程序内置的后台循环;表中没有对应条目并不代表系统不存在定时任务。即使某个定时器的触发时间恰好与峰值重合,也仅能作为排查线索,不能直接作为因果关系的定论。
在公开案例方面,用户 William Long 于 2026-11-01 在 X 平台曾发帖提到,其在特定环境下观察到每分钟出现一次短时 CPU 峰值。这属于单一用户的个案观察记录,既不代表官方的定性结论,也不能推导为所有环境下的通用现象。
面对排查出的任务,应当采取不同的应对策略:
- 自身部署的应用任务:如果排查确认是业务本身的数据库备份、缓存重建或日志归档引发了计算开销,应优先在维护窗口内优化程序逻辑,例如引入任务排队、降低并发处理量或将重载任务改到访问低谷期执行。
- 来源未知的管理组件:如果定位到系统预置或依赖关系不明的进程,切勿照搬网络上的非官方建议去强行终止进程或禁用服务,以免导致系统管理通道异常。正确的做法是整理运行日志,向官方渠道求证。
什么时候先处理已有任务,什么时候才考虑套餐#
在 VPS 运维中,切忌将购买新服务器或升级套餐当作解决未知进程问题的捷径。如果是配置失误、程序死循环或管理组件调度引起的资源开销,迁移到更高配置的机型上同样会消耗算力,不仅浪费预算,还掩盖了真实的系统隐患。
只有当业务规模经过持续评估,确认日常真实的访客请求与计算需求已经稳定超出当前机型的资源边界及一小时平均额度时,才需要考虑调整套餐。搬瓦工的不同套餐系列在网络线路与机房范围上存在明显区别,不能为了解决单纯的算力疑问而盲目购买更昂贵的网络套餐。
以下是官方在售的两档典型配置参考信息:
| 套餐名称 | 核心硬件规格 | 端口速率与网络特点 | 参考整期价格 | 已核验购买入口 |
|---|---|---|---|---|
| Basic 40G / 2GB (PID 45) | 3 vCPU / 2048 MB 内存 / 40 GB 存储 / 2000 GB 月流量 | 1000 Mbps 端口速度,机房示例 USCA_2 | 年付 $99.99(最短周期半年付 $52.99) | 选购 Basic 40G 年付 |
| E-Commerce 40G / 2GB (PID 88) | 3 vCPU / 2048 MB 内存 / 40 GB 存储 / 2000 GB 月流量 | 2500 Mbps 端口速度,机房示例 USCA_9 | 年付 $299.99(最短周期季付 $89.99) | 选购 E-Commerce 40G 年付 |
在做选择时需要注意,E-Commerce 套餐的高溢价主要来自于面向特定访问区域优化的网络线路,并不代表能自动平抑异常进程。参数中的端口速率代表虚拟网卡的接口规格,不是服务商对持续可达带宽的兜底承诺。上述年付价格均为结账时一次性支付整期费用,并非按月分摊扣费;可选的付款周期与库存状态以结算页面实时显示为准。
如需核对更多在售机型与完整规则,可前往 BandwagonHost 官网主入口 或阅读站内的 BandwagonHost 套餐列表。
整理记录与向官方提交工单验证#
搬瓦工提供的是自我管理型(Self-managed)KVM VPS,官方团队负责母机底层硬件与机房网络可用性,操作系统内部的日常运维、软件配置与数据备份由用户自行承担。因此,向官方提交工单时必须提供清晰、规范且只读的客观事实。
如果你怀疑某个持续占用资源的组件与系统模板预装有关,可以准备一份最少必要的日志清单:
- 发生时间与时区:精确记录峰值发生的具体时间戳,并注明系统所处的时区(如 UTC 或 Asia/Shanghai)。
- 业务实际表现:说明在 CPU 冲高期间,网站实际页面是否出现访问缓慢或连接中断。
- 峰值特征:描述峰值持续的秒数、波动的周期规律,以及 KiwiVM 控制面板中是否已出现 CPU 限制警告。
- 核心进程字段:附上通过只读命令抓取到的 PID、父 PID、可执行文件名称(comm)以及运行时长。
- 系统环境基础信息:提供操作系统发行版名称、内核版本以及实例所在的机房代号。
在提交任何记录前,务必执行严格的隐私检查:彻底移除其中的私钥证书、登录密码、API 密钥、命令参数中的敏感字段、客户个人资料以及任何支付信息。工单的核心是询问该组件的具体功能、适用模板范围以及官方推荐的处理方式。提交后应保持耐心,官方服务不承诺固定的响应时限或符合预期的排查结论。
关于账户管理与接口自动化的进一步说明,可参考站内的 BandwagonHost 入门概览、KiwiVM API 指南 以及 官方支持工单说明。
参考与官方数据来源:
- BandwagonHost 服务条款 (Terms of Service)
- BandwagonHost 官方套餐数据目录
- Linux top(1) 手册页
- Linux ps(1) 手册页
- systemd systemctl(1) 手册页
本文资料核验日期:2026-11-03。