DigitalOcean c-32-intel 选购指南:32 核独享企业级算力与 10 Gbps 高吞吐架构
内容更新
为什么大型生产系统需要 32 核独享算力?#
当业务进入高速成长期,微服务集群、大型构建矩阵或高频 API 网关的并发量会呈现指数级增长。如果继续使用中小型云服务器进行水平堆叠,常常会面临连接池膨胀、分布式网络通信开销剧增以及运维拓扑复杂的困境。而在垂直扩展时,如果采用共享型 CPU,多租户资源竞争所导致的延迟毛刺将直接影响整个系统的稳定性。
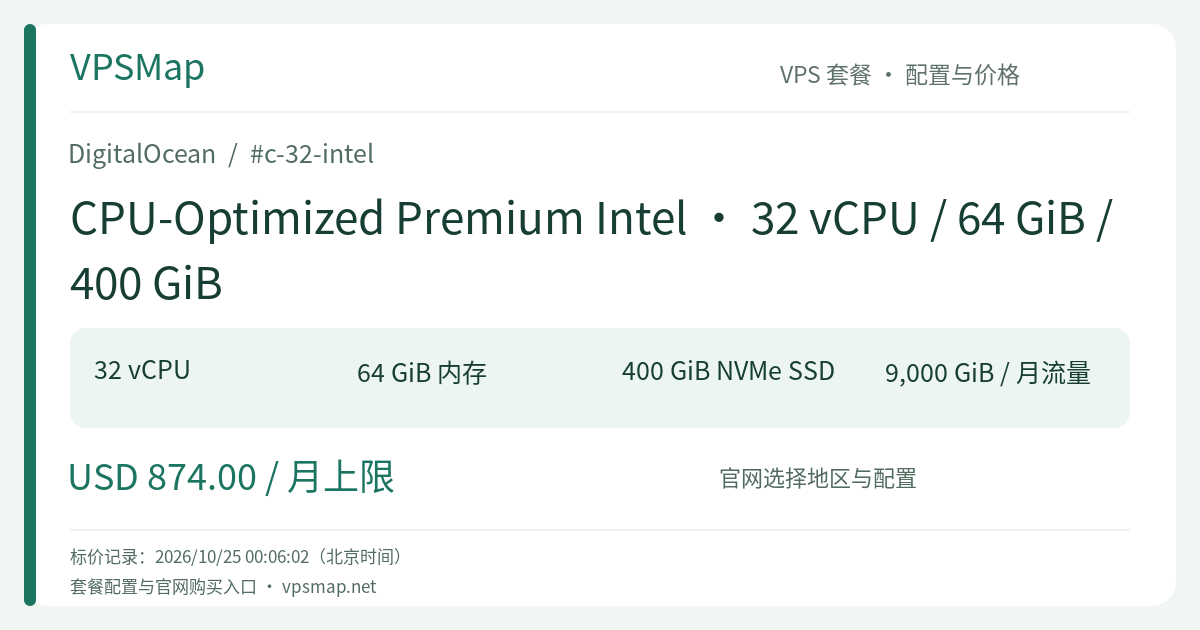
DigitalOcean 的 c-32-intel 是 CPU-Optimized Premium Intel 系列的重型算力机型。它为你锁定 32 个完全独享的物理超线程(采用第 3 代 Intel Xeon Scalable 处理器,主频高于 2.6 GHz),并搭配 64 GiB 内存与 400 GiB 宿主机直连 NVMe 固态硬盘。这是一台能够轻松承载数万并发请求与大规模批处理运算的坚实基石。
架构与硬件特性深度剖析#
1. 32 核独享超线程:平直稳定的性能曲线#
在计算密集型场景下,性能最怕的不是“慢”,而是“不稳定”。c-32-intel 的 32 个核心不与其他用户共享物理超线程,所有 CPU 周期 100% 为你所有。这意味着无论外界网络或宿主机邻居有多忙碌,你的多线程编译任务、视频并行渲染、数据校验运算都能在毫秒级可预期的周期内完成。
2. 2:1 算存比(64 GiB 内存):兼顾高并发与经济性#
与通用型实例动辄给 32 核配置 128 GiB 内存不同,c-32-intel 保持了 2:1 的计算型配比:
- 64 GiB 内存的充足容量:足够支撑高并发 Web 框架(如 Go、Rust、Node.js 集群)维持庞大的连接数与活跃会话,同时也能从容应对大型 C++/Rust 项目构建时的内存峰值。
- 避免闲置浪费:对于以 CPU 运算为主的场景,你不需要为多余且闲置的 64 GiB 内存持续买单,显著压低了单核算力的总体拥有成本(TCO)。
3. 10 Gbps 极速出口与 9,000 GiB 团队流量池#
该机型享有 Premium 级别的高规格物理网络接口,支持高达 10 Gbps 的出方向吞吐能力,数据导出速率相比常规实例提高达 5 倍。套餐内置 9,000 GiB(接近 9 TB)的月度免费公网出方向流量池(入方向免费),无论是作为跨区域微服务枢纽、分布式日志中枢,还是作为流媒体转发源站,网络带宽都十分充沛。
4. 直连宿主机的 400 GiB 本地 NVMe#
标配的 400 GiB NVMe 硬盘直接挂载在宿主机总线上,具备网络块存储无法比拟的高 IOPS 和极低延迟。这为临时编译缓存、解压目录、本地临时数据库和工作日志提供了流畅的读写性能。
典型部署场景#
- DOKS(DigitalOcean Kubernetes)核心工作节点:作为 Kubernetes 集群的主力计算节点,承载数十个高算力微服务 Pod、调度后台队列与无状态 API 服务。
- 大型工程并行自动化构建矩阵:支撑团队自建的 GitLab Runner 或 GitHub Actions 节点,32 核心并发编译,将团队的构建等待时间从数十分钟压缩至几分钟。
- 高并发游戏服务器与模拟引擎:运行多房间、多线程游戏对战服务端或物理交互模拟,确保网络帧同步与事件处理零延迟抖动。
- 大规模高保真音视频转码群集:同时启动多个 FFmpeg 进程,并发处理多路 4K/1080p 视频转码流并直接切片分发。
计费机制与运维建议#
- 月度封顶与按秒计费:该机型支持按秒计费,每月最高计费 672 小时(28 天)。超过 672 小时后直到当月结束,实例都不再产生额外小时费用。
- 关机仍会计费的底层逻辑:由于该机型独占锁定了宿主机上 32 个专用物理超线程和 400 GiB NVMe,在控制台单纯关机(Power Off)依然会持续扣费。如果要短期进行性能压测或版本构建,用完后请务必创建快照(Snapshot)并**彻底销毁(Destroy)**以避免不必要的开销。
- 备份与持久化:系统盘 400 GiB 适合存放操作系统与程序暂存。长期业务数据推荐通过 VPC 私网连接至 Managed Database(托管数据库)或挂载 Volumes 块存储,并开启官方定期备份服务(每周备份增收 20% 费用,每日备份增收 30%)。
选型总结#
如果你需要一台兼具强悍多核并发、企业级 10 Gbps 网络出口与低延迟本地存储的旗舰级计算节点,c-32-intel 能为你的生产业务提供稳定高效的算力支撑。