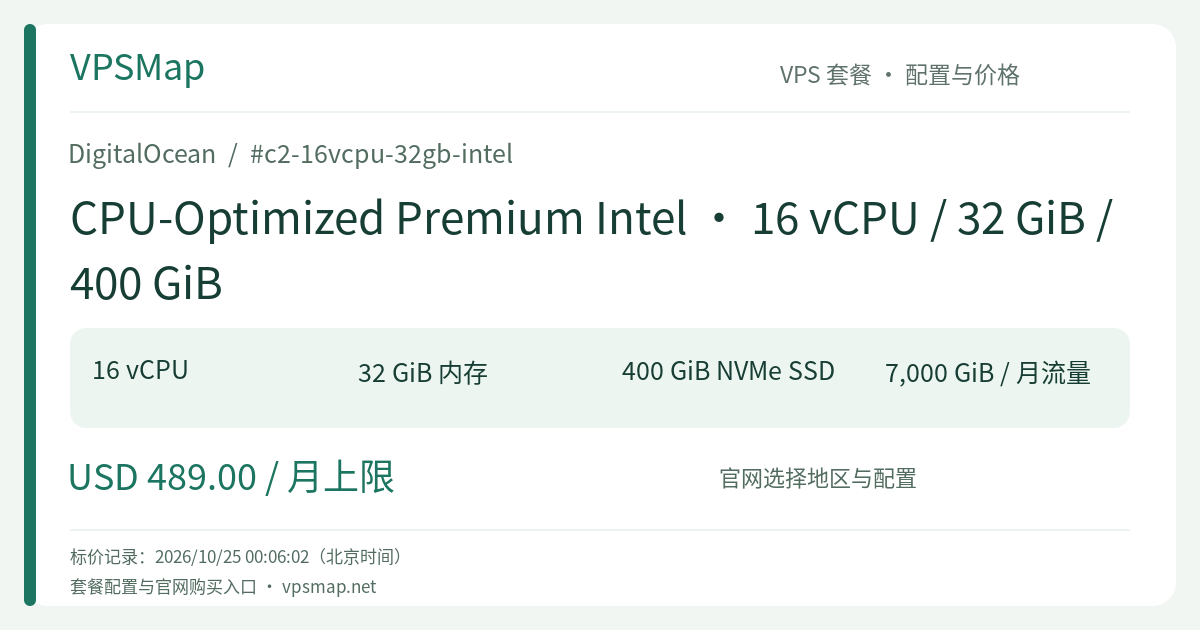
DigitalOcean c2-16vcpu-32gb-intel 深度评测:400 GiB 高速 NVMe 加持的双倍存储算力型实例
内容更新
为什么本地存储容量对 16 核算力如此关键?#
在很多高并发和多任务编译场景中,开发者常常会遇到一个尴尬的局面:16 个独享核心计算速度极快,但标配的 200 GiB 磁盘在面对数十个 Docker 镜像缓存、多分支编译构建产物以及临时解压包时,往往会在运行数天后报警满盘。
c2-16vcpu-32gb-intel 正是为了解决这一痛点而设计的 2X 存储进阶型机型。它保持了 16 核独享 CPU(3rd Gen Intel Xeon Scalable,基频 > 2.6 GHz)与 32 GiB 内存的 2:1 黄金算存比,同时将宿主机直连 NVMe 本地磁盘翻倍至 400 GiB。
核心竞争优势与硬件特性#
1. 宿主机直连 NVMe vs 网络块存储:性能差异不可忽视#
很多工程师在磁盘不够用时,第一反应是通过挂载 DigitalOcean Volumes(网络块存储)来扩容。然而,网络块存储受制于网络协议开销与 IOPS 上限,在面对高并发的小文件读写(如构建过程中的 node_modules、Cargo 缓存、中间编译文件 .o)时,延迟和吞吐量无法与宿主机总线直连的 NVMe 相比。
c2-16vcpu-32gb-intel 提供的 400 GiB NVMe 直接由超线程所在的宿主机主板挂载,具备极高的并发通道和微秒级延迟响应。这意味着:
- 多工程并行构建无 I/O 拥塞:16 个核心同时进行编译读写,不会因为磁盘队列深度爆满而陷入 I/O Wait。
- 无需复杂的清理脚本:构建容器可以保留更多层级缓存,显著加速二次构建时间。
2. 16 核独享超线程:杜绝性能抖动#
与 Basic 系列的共享型 CPU 不同,该机型的 16 个超线程完全锁定给你独占。无论物理机上其他实例正在经历怎样的突发流量,你的计算流水线都能维持平直稳健的执行效率。在自动化部署、批量压测或金融级分析场景下,这种确定性是生产系统不可妥协的底线。
3. 10 Gbps 高速带宽与 7,000 GiB 流量池#
该机型属于 Premium 系列,享有最高 10 Gbps 的物理出口带宽,比普通机型数据导出速度快 5 倍。配合随套餐包含的 7,000 GiB 团队月度免费公网出方向流量(入方向完全免费),你可以轻松应对大体积安装包分发、日志聚合上报或跨地域多集群数据同步。
典型适用场景#
- 重度 CI/CD 构建集群节点:支撑 GitLab Runner、Jenkins 或 GitHub Actions 自建 Runner,容纳数十个并发编译流水线并常驻本地 Docker 镜像层。
- 高频音视频渲染与转码流水线:在本地存储多个 4K 源视频原始素材,完成转码切片后再统一推送至对象存储,避免边网络读写边转码造成的吞吐瓶颈。
- 自建敏捷测试/预发环境数据库:需要导入数百 GiB 真实脱敏数据进行自动化压测与冒烟测试,要求毫秒级查询延迟与高写入吞吐。
- 中型日志与指标收集中心:在节点本地运行 Elasticsearch 或 ClickHouse 节点,进行短期高频写入与热数据分析。
成本与使用注意事项#
- 性价比权衡:相比 200 GiB 基础机型,
c2-16vcpu-32gb-intel每月增量成本仅约 $52(折合每小时约增加 $0.077)。花极小的成本换取 200 GiB 高性能本地 NVMe 空间,免去了维护外部挂载卷的复杂性与 I/O 损耗,在生产环境中非常划算。 - 关机仍会计费:因该机型独占 16 个专用核心与 400 GiB 高速 NVMe,即使处于关机状态,物理资源依然处于锁定占用状态。若需长期停用,请通过制作镜像(Snapshot)后销毁 Droplet 来彻底停止计费。
- 数据持久化建议:本地 NVMe 磁盘伴随 Droplet 生命周期存在。对于核心数据库或不可替代的持久化资产,建议配置异地备份、启用快照(Snapshots)或搭配 DigitalOcean Spaces 进行异地容灾。
选型总结#
如果你需要 16 核强大的稳定计算能力,同时被繁重的编译缓存或本地临时媒体素材困扰,c2-16vcpu-32gb-intel 刚好填补了计算与本地高速存储之间的平衡点。