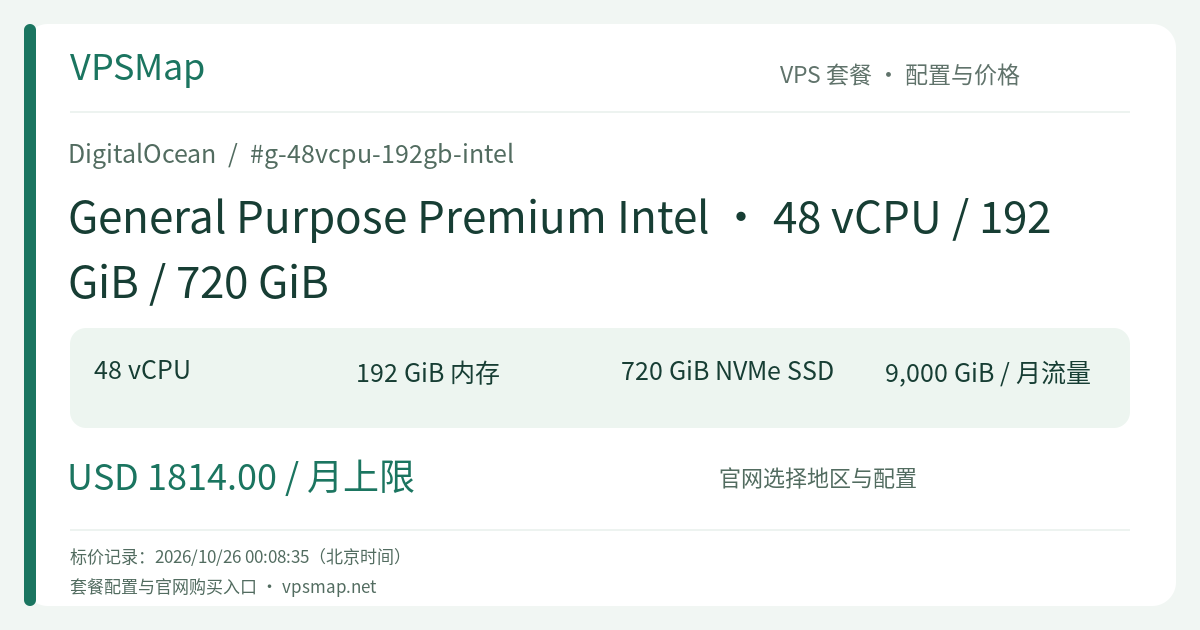
48核 192G 独享算力中枢:支撑超大规模集群与关键业务的设计美学
内容更新
在分布式与微服务架构盛行的今天,许多运维工程师都曾体验过“碎片化陷阱”:为了承载业务,平台部署了上百台 2 核或 4 核的小型虚拟机。然而随着规模扩大,跨节点网络开销剧增,监控指标爆炸,服务间 gRPC 通信延迟不可控,运维人员每天都在处理各种各样的节点偶发性故障。
有时候,最优雅、最稳固的架构方案,恰恰是“化零为整”。
DigitalOcean 的 General Purpose Premium Intel 48 vCPU / 192 GiB(型号标识 g-48vcpu-192gb-intel),就是为这种关键骨干节点量身定制的重型算力平台。它将 48 个独享物理超线程与 192 GiB 巨量内存融为一体,为大型企业级基础设施提供了坚不可摧的算力底座。
48 核心 192G 内存:为大型工作负载提供从容底气#
这台机器的规格不仅体现为参数的庞大,更体现在它所能承载的复杂业务场景:
- 大规格 Kubernetes 核心工作节点(Worker Node):在基于 DigitalOcean Kubernetes(DOKS)或自建集群中,单台 48 核 192G 节点可以承载上百个微服务 Pod。同一节点内的容器通过内部 IPC 与本地回环网络通信,跨服务调用的延迟直接从毫秒级降至微秒级,极大减轻集群网络覆盖层(Overlay Network)的负担。
- 重载 JVM 与企业级中台应用:Java/Scala 生态中的企业级中间件往往对内存与多线程并发极度饥渴。192 GiB 内存能够支撑分配数十吉字节的堆空间(Heap Space),同时为底层元空间、堆外内存(Direct Memory)以及操作系统页缓存留下充足的缓冲池,避免频繁 Full GC 与内存换页。
- 高并发并行计算与 CI/CD 流水线:48 个物理超线程能够并发执行数十个耗费算力的单元测试容器、代码静态扫描任务或并行多架构 Docker 镜像构建,将团队的代码交付等待时间压缩至最短。
硬件纯度:第三代 Xeon Scalable 与 10 Gbps 极速通道#
- 100% 独享算力保障:作为 General Purpose 系列的顶配阶梯,所有 48 个 vCPU 均为 100% 独享超线程。在第三代 Intel Xeon Scalable 处理器的强劲性能下,任何瞬时计算洪峰都能得到即时响应,彻底杜绝邻居虚拟机的任何干扰。
- 10 Gbps 极速网络传输:Premium Intel 系列专属的高达 10 Gbps 出口网络,使得该节点在处理海量客户端请求、内部多节点数据同步或分布式存储备份时,具备极高的网络吞吐冗余。
- 9,000 GiB(9 TB)月度免费出站流量:创建该实例即可为团队的免费带宽池注入整整 9,000 GiB 的配额。所有团队内的 Droplet 均可共享这笔巨额流量池,入站流量完全免费,同一 VPC 私有网络内互联完全免流。
720 GiB NVMe 磁盘的系统定位#
该实例配备了 720 GiB 宿主机直连的高速 NVMe SSD。对于这样一台算力强劲的计算节点,720 GiB 恰到好处地扮演了“轻快而坚固”的角色:
- 为容器运行时镜像分层、本地快速日志缓存以及临时编译构建工作区提供了充裕且超低延迟的物理介质。
- 对于海量持久化数据,建议与挂载型 Volumes 块存储或 Spaces 对象存储协同工作,实现算力计算与持久资产的优雅解耦。
财务透明度与运维建议#
- 透明的 672 小时封顶计费:系统精确按秒计量,但在每个计费周期(按 28 天 / 672 小时计算)达到月度封顶上限后便不再递增。对于需要长期稳定运行的关键节点,预算高度确定;若用于短期压力测试或算法训练,按秒计费也能将支出精确控制在实际运行周期内。
- 保留机制与生命周期管理:若实例在控制台中执行“关机”,其专属超线程、内存与 NVMe 仍处于独占占用状态,计费依然会继续。如果阶段性任务结束,请在做好系统快照后执行销毁操作。
- 安全与自动化备份:如此大规格的核心节点,承载着不可替代的业务责任。创建时建议直接勾选自动化增量备份功能(每周仅按实例费用的 20% 计费),为核心系统添加一层坚固的安全防线。
如果你的系统正在寻求性能整合,希望用更高密度、更稳定的骨干架构替代繁琐杂乱的微型服务器碎片,这款 48 核 192G 旗舰级实例将是带领业务迈向全新体量的可靠基石。