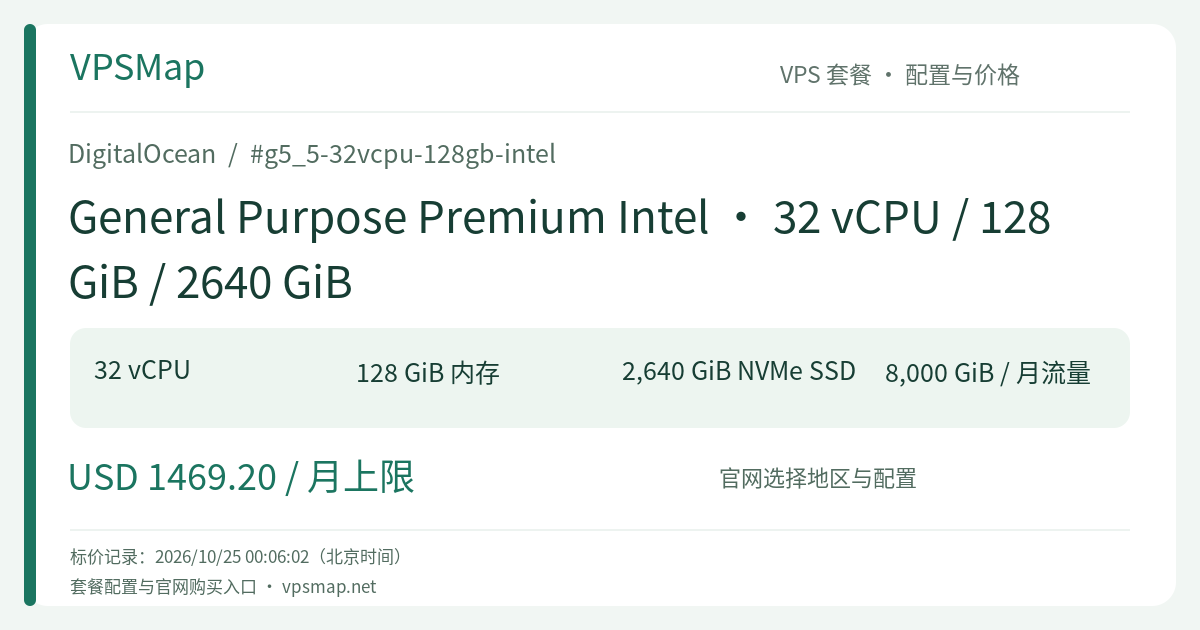
2.6TB 直连 NVMe 的极致 I/O 盛宴:DigitalOcean 32核大盘通用型算力全景评测
内容更新
在现代化高并发系统的架构设计中,有一个经常被忽视的性能分水岭:单节点海量数据的高频随机写入。
大多数云厂商解决大存储需求的方法是“挂载网络云盘”,但当每秒有数以万计的并发事务需要落盘、或者数百 GB 的数据流需要实时解压与重构时,网络协议栈的延迟与带宽上限就会成为整个业务系统的致命瓶颈。
DigitalOcean 的 General Purpose Premium Intel 32 vCPU / 128 GiB / 2640 GiB(型号标识 g5_5-32vcpu-128gb-intel),以一种非常直接硬核的方式打破了这一限制:它直接在宿主机物理层为你分配高达 2640 GiB(约 2.64 TB)的极速 NVMe SSD 空间,将 32 颗独享计算核心、128 GiB 大内存与巨量直连存储融为一体。
2640 GiB 本地 NVMe 究竟意味着什么?#
这绝不是一个简单的“大硬盘虚拟机”,而是专为重载 I/O 业务定制的单机吞吐猛兽:
- 彻底消除跨网络 I/O 抖动:2640 GiB 空间全部挂载于底层 PCIe 总线,避免了云盘通过机房网络交换机中转带来的额外微秒级延迟与带宽排队。不管是高频 WAL 刷盘还是极速读取海量日志,I/O 响应时间稳定在极低水平。
- 开辟超大容量高性能本地缓存与暂存区:
- 音视频与多媒体转码:高清视频切片、渲染中间帧和批量合成可以在 2.6 TB 空间内以每秒数吉比特的速率肆意吞吐,处理完毕后再异步上传到 Spaces 对象存储。
- 大型 CI/CD 构建集群:作为大型单体仓库(Monorepo)或 Android/iOS/C++ 构建宿主机,可容纳数百个并发构建产物与缓存目录,编译耗时成倍削减。
- 大数据流式处理与消息缓冲:作为 Kafka、Pulsar 或 ClickHouse 节点,2.6 TB 的原生 NVMe 能够直接充当高吞吐的消息队列日志段(Log Segments)落盘介质,吞吐性能远超网络挂载盘。
坚如磐石的算力与网络底盘#
与巨量存储并肩作战的,是同样无可挑剔的系统规格:
- 32 个独享 Intel Xeon 核心:基于第三代 Intel Xeon Scalable(Ice Lake 架构),100% 独享超线程。在面临大规模复杂数据查询、并发解析和高压加密计算时,没有任何外部邻居干扰,算力供给稳定平直。
- 128 GiB 内存池:4:1 的内存配比足以在内存中建立起庞大的页缓存(Page Cache)和应用工作集,让频繁读取的热数据无需真正触碰硬盘,大幅减轻存储总线压力。
- 最高 10 Gbps 出口与 8,000 GiB 免费流量:Premium Intel 系列专属的高达 10 Gbps 网络能力,配合每月 8,000 GiB 的团队出站流量池,无论是对内节点同步还是对外服务分发,都能轻松应对峰值洪峰。
架构简化:少即是多的工程哲学#
选用这种“超大本地盘大规格实例”,还能为运维团队带来显著的架构收益:
- 无需管理复杂的块存储生命周期:避免了挂载网络卷、处理挂载失败、管理独立快照链以及排查云盘网络脱开等一系列复杂的运维琐事。
- 降低分布式系统的网络拓扑复杂度:在许多业务早期或中期,用单台具备 32 核 128G 2.6TB NVMe 的高规格节点承载主库与关键服务,其性能、可控性与故障排查难度,往往远好于过早拆分为 10 台小机器加网络盘的复杂分布式集群。
计费与运维要点#
- 透明的用量上限:按秒计费,每自然月最多计费 672 小时。即使整月全天候满载运行,费用也严格锁定在月度封顶上限;如果仅用于数天的大型批处理或迁移任务,用完即毁,按秒精算。
- 存储特性与容灾:宿主机直连 NVMe 具有极致性能,但为了应对底层硬件维保风险,生产部署时应配置完备的容灾方案。利用 DigitalOcean 的自动化增量备份功能,或通过私有 VPC 将关键变更实时复制到同机房从机,即可兼顾极致速度与数据安全。
如果你的系统正在遭受外挂存储的 I/O 瓶颈,或者需要一个拥有超大极速本地磁盘的 32 核计算怪兽,g5_5-32vcpu-128gb-intel 将是帮助你撕开性能天花板的王牌利器。