近 4TB 本地 NVMe 终极性能怪兽:DigitalOcean 48核 192G 存储通用型实战全景
内容更新
当现代软件工程面对极端工作负载时,技术选型往往会陷入两难境地:要么采购运维门槛极高、交付周期漫长、弹性几乎为零的物理裸金属服务器;要么在公有云上拼凑复杂的分布式虚拟机集群,在成百上千个网络存储卷与跨机房拓扑间疲于奔命。
有没有一种方案,既能拥有公有云的按秒计费、API 编排与秒级交付弹性,又能拥有比肩裸金属的极致计算、内存与超大规模物理本地 NVMe 性能?
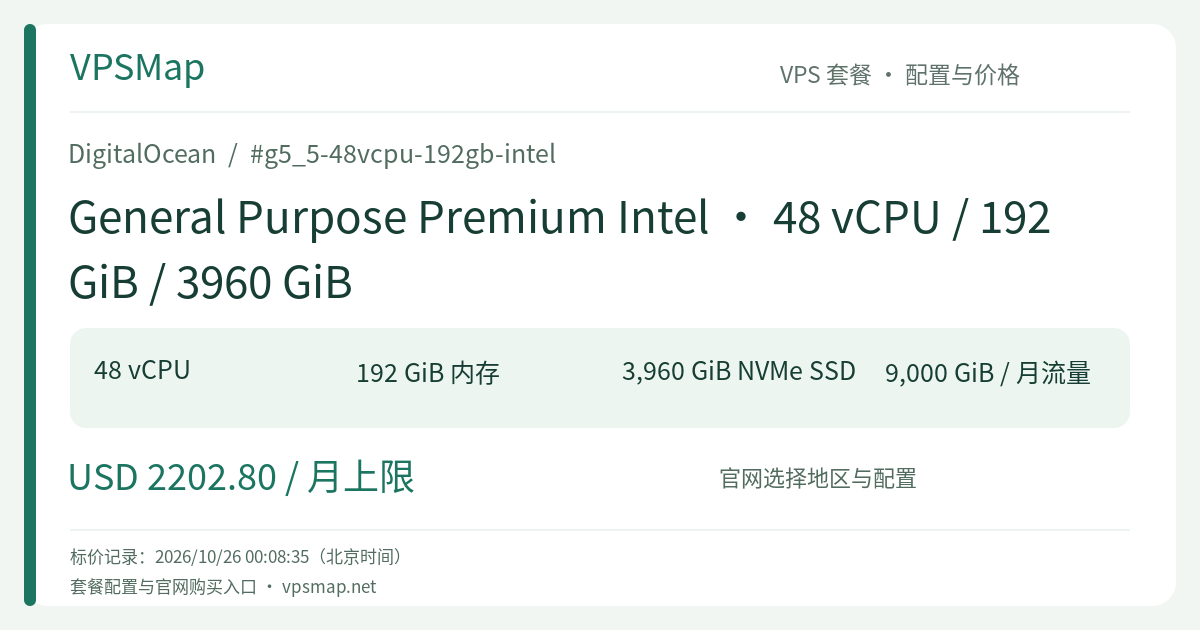
这正是 DigitalOcean General Purpose Premium Intel 48 vCPU / 192 GiB / 3960 GiB(型号标识 g5_5-48vcpu-192gb-intel)存在的意义。它直接在虚拟化宿主机物理层打通了一座近 4 TB(3960 GiB)极速 NVMe 的存储洪流,并将 48 个独享 Intel Xeon 核心与 192 GiB 内存倾注其中,构筑了通用云实例的性能天花板。
3960 GiB 宿主机直连 NVMe:彻底打破 I/O 天花板#
在很多人的认知中,云上几百吉字节的磁盘已经很大了,而近 4 TB 的宿主机物理直连 NVMe 则是完全不同的概念:
- 超越网络块存储的物理限制:挂载型云盘即使配置了极高的预置 IOPS,也必须受制于网络虚拟化封装与虚拟网卡通道的吞吐上限。而这台机器上的 3960 GiB 存储直接由物理宿主机主板的 PCIe 总线直通,能够提供极致的吞吐带宽与极低的读写寻道延迟。
- 单机容纳巨型超重载数据库:无论是数十亿级行数的大规模时序数据库(TimescaleDB、InfluxDB),还是高吞吐的分布式列式分析引擎(ClickHouse),近 4 TB 的本地原生存储足以让你把未来数年的核心数据完整存放在极速本地盘上,无需频繁进行冷热分层归档。
- 超大规模多媒体与 AI 数据预处理:面对数万小时的 4K 视频批量转码、超高分辨率卫星遥感图像拼合,或者大型多模态 AI 模型的本地训练集解压与预处理清洗,3960 GiB 的极速读写空间能够保证多进程完全以满负荷速率读写,不再有任何等待。
48 独享核心与 192G 内存的统治级算力#
- 100% 独占硬件超线程:由第三代 Intel Xeon Scalable(Ice Lake)强力驱动,48 个 vCPU 均为物理核心一对一独享。配合 AVX-512 高级向量扩展指令集,计算密集型与高并发网络任务的吞吐力表现平直稳定。
- 192 GiB 超大内存容量:4:1 的黄金配比使得该机器拥有深不可测的内存缓冲池。你可以将数十吉字节的频繁查询结果、复杂倒排索引或 Redis 缓存直接钉死在内存中,大幅减轻存储总线的负担。
- 10 Gbps 网络与 9,000 GiB 流量池:Premium Intel 系列专属的高达 10 Gbps 出口网络带宽,让这台巨兽无论是对公网提供服务,还是向同可用区 VPC 内的从属节点分发数据,都能轻松拉满带宽。每月 9,000 GiB 的团队出站流量自动累加,入站完全免费。
单机整合的工程美学:为什么有时候“单大节点”胜过“复杂分布式”?#
在现代架构体系中,“过度分布式”常常是研发效率的隐形杀手。维护 20 台微型节点需要处理复杂的分布式锁、跨节点网络分裂、配置同步与难以排查的链路追踪。而选择一台各方面均处于顶峰的 48核 192G 4TB NVMe 实例,能够带来质的改变:
- 单节点内零网络开销通讯:所有服务、组件、缓存与本地数据库均通过本地高速内存与 UNIX 域套接字互通,跨组件通信延迟直接归零。
- 极简的运维与监控架构:只有一台机器需要配置安全组、补丁升级与监控告警,极大缩减工程团队的心智负担。
计费规则与高可用部署建议#
- 按秒计费与月度封顶:依然享受 DigitalOcean 标志性的 672 小时(28 天)月度计费封顶机制。即便整月全负荷运行,总支出完全透明;若用于阶段性大型数据迁移或密集渲染,可随时开通并按秒结算。
- 关机仍计费原则:由于 48 个计算核心、192 GiB 内存与近 4 TB 的物理直连 NVMe 被全天候专属锁定在该物理宿主机上,实例处于关机状态时仍会计费。若不再使用,请制作快照镜像后予以彻底销毁。
- 数据安全与高可用规范:鉴于单节点存储的数据规模极其庞大,建议在业务层利用 DigitalOcean VPC 私网搭建跨机器的主从流复制机制,并配置控制台自动化增量备份(每周备份仅占实例费用的 20%),确保业务在享受超凡单机性能的同时,具备企业级的数据冗余与灾备韧性。
如果你正在寻找云端通用架构下的算力与存储终极形态,希望彻底击碎 I/O 与并发瓶颈,这款 48 核 192G 3960G NVMe 实例就是那把能够帮你横扫一切性能阻碍的终极重锤。