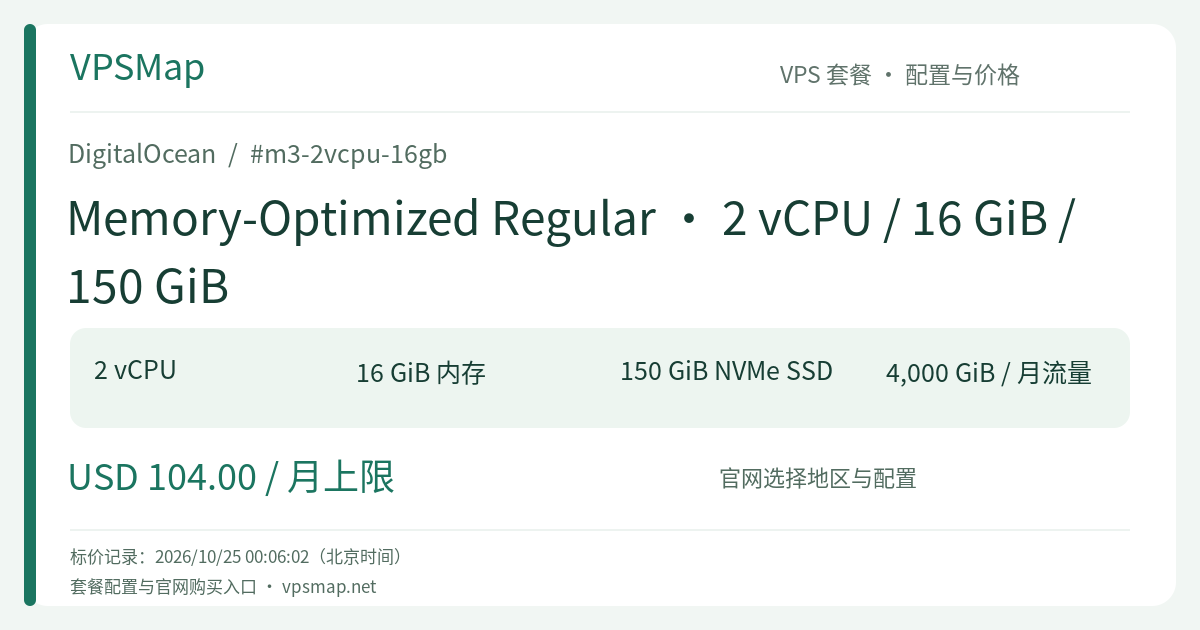
DigitalOcean m3-2vcpu-16gb 深度解析:三倍本地 NVMe 空间打造低延迟高吞吐数据库工作站
内容更新
为什么许多团队会为数据库存储架构感到纠结?#
在规划生产数据库部署时,很多架构师都会面对这样一个权衡取舍:选用基础款的内存型服务器,本地磁盘往往只有 50 GiB 上下;随着业务数据增长、索引增加以及 WAL 日志的积累,磁盘空间很快捉襟见肘。
此时常规的解法是挂载网络块存储(如挂载云硬盘 Volume)。然而,云硬盘虽有弹性扩展优势,其数据读写却必须通过虚拟网络链路传输。对于高频点查、大量复杂 JOIN、或者在突发流量下需要密集刷盘的 OLTP 数据库而言,网络存储无论在 IOPS 还是在随机写入延迟上,都无法与直连宿主机的物理 NVMe 相比。每次几毫秒的等待累加起来,就构成了系统整体响应延迟的隐形杀手。
DigitalOcean 推出的 Memory-Optimized Regular · 2 vCPU / 16 GiB / 150 GiB(型号 m3-2vcpu-16gb),正是为了彻底解决这种“既要低延迟超大缓存、又要充足本地物理盘位”的需求而设计。
核心技术优势与架构解构#
1. 三倍本地 NVMe 空间带来的从容冗余#
相比基础版 m-2vcpu-16gb 的 50 GiB 盘位,m3-2vcpu-16gb 将直连宿主机的 NVMe 空间直接提升到 150 GiB。这一改变在工程实践中意味着什么?
- 数据表与索引完全独立存放:你可以为 MySQL 或 PostgreSQL 规划几十甚至上百吉字节的真实生产数据,同时完整保留复合索引与倒排索引,无需担忧空间告警。
- WAL 与 Binlog 无压力持久化:事务日志能够保留更长的历史周期,给从库同步、定时增量备份以及故障回滚留出充足的时间窗口。
- 临时表空间扩展:执行复杂排序(
ORDER BY)或多表哈希聚合查询时,若临时数据集超出内存上限,系统能够借由高速 NVMe 迅速完成外存排序,杜绝由磁盘空间耗尽导致的查询中断。
2. 8:1 内存配置支撑极致缓存命中率#
16 GiB 独占物理内存与 2 颗专用 vCPU 组合,完美契合标准数据库的吞吐特性。以 PostgreSQL 为例,你可以为 shared_buffers 分配 4 到 6 GiB,同时留出 8 GiB 以上的操作系统 Page Cache。绝大多数频繁访问的冷热混合数据在进入存储器之前,就已经在内存中完成了命中,真正让直连 NVMe 聚焦于纯粹的高速写入与持久化操作。
3. 避免网络块存储瓶颈的确定性体验#
挂载的网络云盘受限于网络带宽与节点吞吐上限,在并发突增时可能出现 I/O 排队现象。而 m3-2vcpu-16gb 的 150 GiB 磁盘直接走宿主机的 PCIe 总线,硬件级并行通道将 I/O 阻塞时间压制在亚毫秒级别,提供极其线性的延迟表现。
最具性价比的真实落地场景#
- 单机自建中型关系型数据库:承载电商系统、SaaS 核心账单库或社交动态数据库,满足 50~100 GiB 数据量级下的全生命周期读写。
- 高可靠 Redis / KeyDB 持久化实例:不仅利用 16 GiB 内存充当高速数据中枢,150 GiB 的大磁盘还能轻松容纳密集的 AOF(Append Only File)日志与每日 RDB 快照,杜绝备份写满磁盘的运维隐患。
- 轻量搜索与日志汇聚节点:部署单节点 Elasticsearch 或 Meilisearch,既有充裕内存满足倒排索引加载,又有 150 GiB 本地空间承载近几个月的高频文档检索。
升级与选型边界#
- 只读扩展还是向上垂直扩容:若你的数据库瓶颈已经从存储容量转向了海量并发连接导致的 CPU 算力上限(如 2 颗核心持续维持在 85% 以上),下一步应考虑纵向升级到 4 核 32 GiB 级别的
m3-4vcpu-32gb,或者引入读写分离架构。 - 冷备与灾备策略:本地 NVMe 拥有极高读写性能,但由于它是与宿主机深度绑定的,因此生产环境下建议结合 DigitalOcean 的自动快照策略(如每日备份)或开启定期异地对象存储(Spaces)同步,构建双重安全屏障。
网络与成本收益分析#
该实例每月配备 4,000 GiB 的出站流量配额,并支持全队流量池共享;配合 2 Gbps 的网络端口,与内网 VPC 中的微服务集群通信延迟极低。相比通过低配基础机型外挂大容量云盘并承担额外的网络 I/O 损耗,m3-2vcpu-16gb 将高容量 NVMe、海量内存与独享核心打包于单一实体内,展现出显著的性能优势与运维确定性。
需要为业务核心库配置充裕空间与极速存储时,可直接在 DigitalOcean 控制台部署该实例。