DigitalOcean m6-2vcpu-16gb 深度解析:6 倍直连 NVMe 打造大容量内存密集型单机节点
内容更新
为什么大容量本地存储对于内存型实例不可或缺?#
在很多典型的现代数据处理场景中,我们经常遇到这样一类特殊的系统负载:它们对 CPU 算力的要求相对克制(2 个稳定的专用核心足以支撑日常管道摄入与查询处理),需要 16 GiB 的稳定内存作为运行时工作区与高效文件系统缓存(Page Cache),但对物理存储空间与原生 I/O 速度却有着近乎贪婪的需求。
例如:
- 存放数周至数月指标数据的 Prometheus / VictoriaMetrics 监控时序库;
- 维护高吞吐事件流回溯的单节点 Kafka / Redpanda 消息代理;
- 承载数十万到数百万条图文结构化数据的 Elasticsearch / Meilisearch 检索服务。
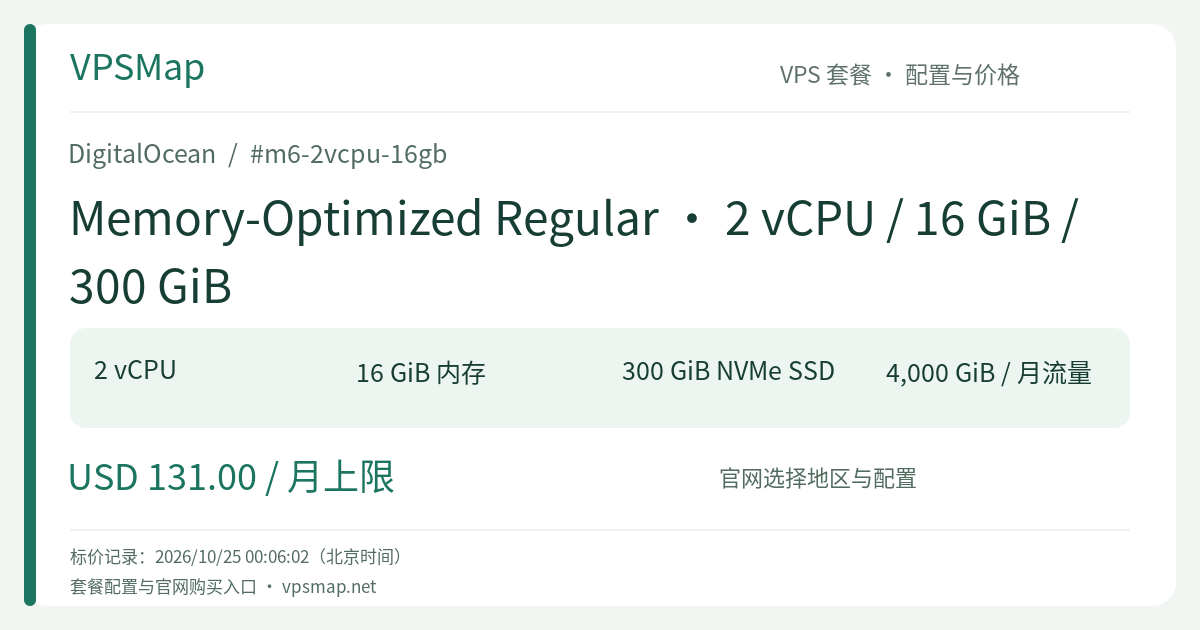
如果在这些场景中使用标准的 50 GiB 基础机型,存储很快就会爆满;而如果外挂网络云盘,又会因为频繁的历史回溯与索引查询带来难以忽视的网络 I/O 延迟。为此,DigitalOcean 提供了 Memory-Optimized Regular · 2 vCPU / 16 GiB / 300 GiB(型号 m6-2vcpu-16gb),直接把宿主机原生的高速 NVMe 存储拉满到了 300 GiB。
架构亮点与技术剖析#
1. 6 倍本地 NVMe 扩容:重度数据流的原生归宿#
相比于标准款的 50 GiB,m6-2vcpu-16gb 将本地 NVMe 空间整整翻了 6 倍至 300 GiB。这不仅仅是数字的增加,更是系统架构设计自由度的跃升:
- 持久化分区彻底解绑网络依赖:300 GiB 的容量足以容纳持续数月的高频日志、指标以及数据库增量变更(CDC)流,数据读写完全在宿主机内部完成,免受网络波动干扰。
- 超低 I/O 延迟保障快速检索:当检索系统需要从磁盘按块(Segment)加载索引数据时,直连 NVMe 的并发随机读取能够瞬间完成调度,大幅削减慢查询数量。
2. 独享双核 + 16 GiB 内存:软硬件协同的平衡之道#
有些工程师会担心:2 个 vCPU 配 300 GiB 磁盘会不会“小马拉大车”?答案取决于工作负载类型。对于以“高吞吐摄入、中等并发检索、大容量持久化”为特征的系统,CPU 大多数时间只负责解析协议和网络封包,算力并不构成瓶颈;相反,内存大小与磁盘 IOPS 才是制约系统生死的核心命脉。
- 16 GiB 的内存允许你将关键服务(如时序库主进程或搜索引擎守护程序)的内存占用锁定在 8
10 GiB,剩余的 68 GiB 留给操作系统充当激进的 Page Cache,有效提升热点磁盘块的内存二次命中率。 - 独享硬件线程确保了即便后台正在执行大规模数据压缩(Compaction)或合并操作,前台 API 的读写请求依然能够获得稳定的调度优先权。
黄金应用场景矩阵#
- 企业自建时序监控基础设施:作为集中式 Prometheus、Thanos 或 InfluxDB 节点,将海量监控指标保存在本地 NVMe 上,满足较长周期的指标回溯需要,避免依赖复杂的多层对象存储架构。
- 事件日志与消息流暂存节点:运行具备多日数据留存策略的 Kafka/RabbitMQ 消息中间件,300 GiB 的本地高速空间确保消息在大量堆积时仍能保持高速持久化,不会因为磁盘满载而触发限流。
- 内容丰富型搜索引擎节点:部署中等体量的 Elasticsearch 或 OpenSearch 单机实例,让索引片段平稳分布在本地 NVMe 磁盘上,获得远超网络云盘的聚合搜索吞吐。
部署与运维策略建议#
- 关注并发 CPU 开销:虽然 2 核独享算力对于大部分数据吞吐已绰绰有余,但如果你计划在 300 GiB 数据上运行极其复杂的重度分析统计(如涉及全表正则匹配或大型分布式聚合计算),建议适时考虑升级至 4 核规格的
m6-4vcpu-32gb。 - 配合快照与异地容灾:本地大容量 NVMe 是单机高性能的基石,建议通过 DigitalOcean 的备份服务与定时任务,将关键归档定期推送至 Spaces 对象存储,确保业务兼具高速度与高灾备冗余度。
流量配合与全队收益#
m6-2vcpu-16gb 同样享有 2 Gbps 端口与每月 4,000 GiB 的出站流量池配额,入站流量全程免费。当作为内部微服务的公共时序数据库或日志中心时,内网 VPC 流量完全免费,不会消耗任何公网传输配额,极大降低了基础设施的隐性运营成本。
如果你的服务正在寻找高内存、大容量且具备极低 I/O 延迟的专属宿主,可直接在 DigitalOcean 控制台部署该实例。