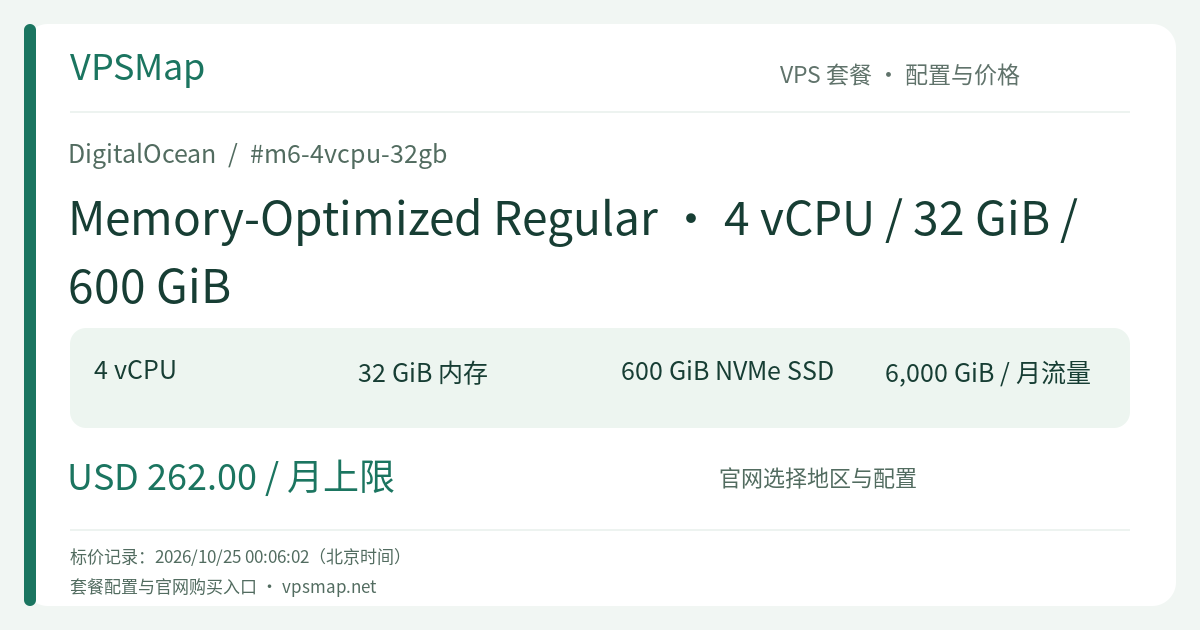
DigitalOcean m6-4vcpu-32gb 深度解析:600 GiB 极限直连 NVMe 与 32 GiB 内存的重载存储性能怪兽
内容更新
当大规模持久化存储遇上低延迟严苛挑战#
在很多高吞吐、重持久化的生产级架构中,工程团队往往会被一个看似简单的存储问题逼入死角:
- 系统拥有高达数百吉字节的活跃数据与历史记录;
- 读写请求要求极低的响应时间(如 P99 延迟小于 10ms);
- 每日增量数据持续流入,伴随着频繁的本地随机读写与全盘索引重构。
如果选择传统的云架构路线——使用普通云主机外挂 500 GiB 以上的网络块存储(Volume),你很快会发现:一旦业务并发冲高,网络 I/O 吞吐上限与网络传输延迟会迅速成为瓶颈,磁盘队列长度(Queue Depth)居高不下,数据库的锁等待和慢查询日志开始疯狂报警。
此时,唯一的优雅解法就是回归物理直连:将超大容量的高速 NVMe 固态硬盘直接安置在宿主机 PCIe 通道上,与 CPU 和内存实现零中继的硬件级互通。
DigitalOcean 推出的 Memory-Optimized Regular · 4 vCPU / 32 GiB / 600 GiB(型号 m6-4vcpu-32gb),就是这一领域的终极形态。它在 4 颗独享计算核心和 32 GiB 物理内存的基础上,直接装载了高达 600 GiB 的本地高速 NVMe 硬盘,打造出一台性能极为纯粹的重载单机数据堡垒。
核心硬件特性与架构收益#
1. 600 GiB 极限本地 NVMe:摆脱外部卷束缚#
相比入门款的 100 GiB,m6-4vcpu-32gb 将本地 NVMe 空间翻整整 6 倍。这一硬件规格直接改变了系统的存储架构设计:
- 海量活跃数据集本地化:无需对 300~500 GiB 规模的数据库进行复杂的应用层分库分表或冷热分离,整库直接驻留在本地高速 NVMe 上,运维复杂度大幅降低;
- 无惧突发 I/O 洪峰:直接挂载宿主机总线的 NVMe 硬盘具备极高的并发通道与读写带宽,在执行数据库全量导出、夜间大批次 ETL 清洗或复杂全盘聚类分析时,能够以极高吞吐快速跑完,不影响前台核心业务;
- 亚毫秒级事务确认:事务提交时的 fsync 操作直接在本地硬件完成,彻底规避了网络块存储可能出现的丢包重传和延迟毛刺。
2. 4 核专用算力 + 32 GiB 内存的默契协同#
- 大内存缓存保护屏障:32 GiB 内存可以划分 20 GiB 以上供数据库缓冲池或搜索引擎堆内存使用,剩下的 10 GiB 作为高效 OS Page Cache,让最热的数据频繁在内存中完成交互;
- 独占执行核心无调度损耗:4 个 dedicated vCPU 保证了即使在持续高吞吐的日志摄入和后台段归并(Segment Merge)过程中,前台用户 API 的响应依然平稳可控。
典型高价值应用场景#
- 大容量企业级搜索引擎节点:部署 Elasticsearch、OpenSearch 或 Solr 节点,将海量商品索引、文档库与高频日志存储在 600 GiB 本地 NVMe 上,满足数百 GB 数据规模下的亚秒级模糊检索。
- 重度事件流与流处理集群:作为 Apache Kafka、Redpanda 或 Pulsar 的核心代理节点,支持数周以上的密集消息回溯窗口,从容应对下游微服务的大规模重放需求。
- 大型综合生产型数据库主库:支撑具有庞大历史订单、复杂关联关系的大型 PostgreSQL 或 MySQL 生产数据库,提供充足的容量冗余与顶级的读写响应速度。
架构与运维最佳实践#
- 灾备与快照协同:由于 600 GiB 的存储属于直连宿主机的物理盘位,建议配合 DigitalOcean 的自动快照策略,或通过定时任务将关键冷备数据转储至 S3 兼容的 Spaces 对象存储中,构建高可用与容灾兼备的弹性架构。
- 监控 I/O 与 CPU 饱和度:在业务高峰期密切观察 4 颗核心的利用率,如果由于业务过于复杂导致 CPU 长期处于 85% 以上的高位,应考虑横向添加从库分流只读压力。
网络互联与带宽价值#
该实例享有 2 Gbps 网络接口,并直接享有每月 6,000 GiB 的团队出站流量池配额,入站流量完全免费。在团队共享流量池的机制下,其他实例未使用的带宽会自动汇聚对冲;配合数据中心内免费的 Private VPC 内网通信,使这台承载 600 GiB 海量数据的核心节点在与微服务集群交互时,既快如闪电又没有任何隐形带宽开销。
如需为你的核心数据架构配置顶级大容量直连 NVMe 性能怪兽,可直接在 DigitalOcean 控制台部署该实例。