DigitalOcean 16核 128G 存储优化型 Premium Intel 深度评测:宿主机直连 NVMe 与高并发数据库的黄金平衡点
内容更新
为什么生产级数据库需要“存储优化型”?#
在公有云架构中,绝大多数团队遭遇性能瓶颈时,第一反应往往是纵向升级 CPU 核心数。然而,分析真实生产环境的监控指标就会发现,关系型数据库(如 PostgreSQL、MySQL)、分布式检索(如 Elasticsearch、OpenSearch)以及重度写入的时序库(如 Prometheus、TimescaleDB),其吞吐量塌陷往往不是因为算力不足,而是撞上了存储 I/O 墙与网络块存储延迟抖动。
常规云服务器挂载的网络块存储(Block Storage Volume)虽然具备灵活扩容的优势,但数据访问必须经过宿主机虚拟化网卡、物理网络交换机以及分布式存储集群。一旦遇到短时并发高峰或刷盘激增,毫秒级甚至微秒级的网络波动就会放大为事务锁等待与连接池枯竭。
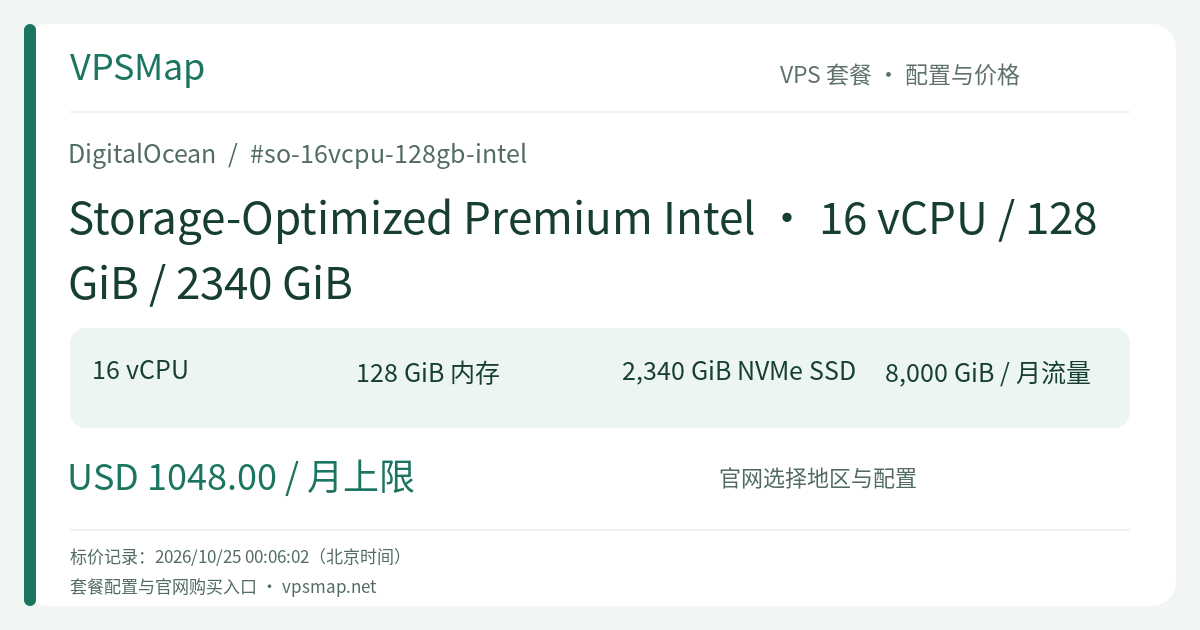
DigitalOcean 这款 so-16vcpu-128gb-intel(Storage-Optimized Premium Intel)正是为终结这种不确定性而生。它将 2340 GiB NVMe 固态硬盘直接挂载在宿主机硬件总线上,让 I/O 请求完全绕开网络协议栈,在物理总线级别实现超低延迟与极高并行读写性能。
硬件规格深度解析与架构优势#
这款实例不是通用云主机的简单堆砌,其每个硬件维度的配比都经过精心设计:
1. 16 颗 100% 独享 vCPU(Premium Intel)#
采用第三代 Intel Xeon Scalable(可扩展)处理器,每一个 vCPU 严格绑定宿主机底层物理超线程,不与任何邻居租户共享计算周期。无论后台正在执行复杂的全文检索排序、大规模数据解压,还是数据库并发 VACUUM,计算延时均保持绝对稳定,彻底杜绝“吵闹邻居(Noisy Neighbors)”现象。
2. 128 GiB 运存(8:1 黄金内存比)#
保持了与内存优化型一致的 8 GiB/vCPU 黄金比例。对于 16 核心配置而言,128 GiB 意味着:
- MySQL / PostgreSQL:可为 InnoDB Buffer Pool 或
shared_buffers分配 80–90 GiB,让绝大多数高频访问的索引与活跃行常驻物理内存; - Elasticsearch:分配 31 GiB JVM 堆内存以规避 Compressed OOPs 失效,剩余近 90 GiB 完全交由 Linux 内核作 Page Cache,为 Lucene 索引文件的只读映射提供无损加速。
3. 2340 GiB 宿主机直连 NVMe 固态#
这是本款实例的核心灵魂。NVMe 原生协议专为闪存高并行性打造,拥有上万深度队列与极微延迟。与网络盘相比,本地直连 NVMe 能在数万 QPS 的随机写入和重度 WAL 预写日志刷盘场景下,将每次 fsync 耗时压制在亚毫秒级,防止数据库在事务提交时发生串行阻塞。
4. 10 Gbps 高速外网接口与 8000 GiB 流量池#
Premium Intel 规格自带高达 10 Gbps 的网络输出能力,相比常规 CPU 实例提速高达 5 倍。配合 8000 GiB 的出站流量配额(入站流量全免),在执行节点间主从复制、分布式分片数据搬迁或大规模日志同步时,绝不会在网卡层遭遇吞吐瓶颈。
核心适用场景#
| 业务场景 | 实际痛点 | 本配置的解决方案 |
|---|---|---|
| 中大型 MySQL / PostgreSQL 主库 | 写入高峰期网络盘 IOPS 受限,导致 WAL 刷盘阻塞连接池 | 2340 GiB 本地 NVMe 释放总线级写入速度,128G 内存承载大缓冲池 |
| Elasticsearch / OpenSearch 热节点 | 密集索引与高并发搜索争抢磁盘与内存缓存 | 31G 堆内存 + 90G 系统文件缓存,2.3TB NVMe 承载热索引瞬时写入 |
| 时序监控底座(Prometheus / VictoriaMetrics) | 千万级时间线高频采样写入,查询聚合耗时长 | 16 颗独享核心加速复杂 PromQL 聚合计算,本地高速盘应对持续追加写 |
| 高性能 Kafka / Pulsar Broker | 消息落地顺序写带宽要求高,消费者回溯读取频繁 | 充分利用 NVMe 吞吐与 10 Gbps 极速网卡,保障高吞吐流式管道稳定 |
成本与投资回报分析($1,048/月)#
以标价 $1,048/月(折合 $1.55952/小时) 审视这款机器,它面向的是严肃的企业级生产负载。DigitalOcean 采用透明的秒级计费并设定了 每月 672 小时(28 天)封顶上限,即使当月运行满 744 小时也只按 672 小时计费,超出小时数完全免费。
为什么说这个价格极具竞争力?
- 省去高阶网络存储的附加账单:在主流公有云中,若想通过网络挂载云盘达到相匹配的 IOPS 与吞吐容量,往往需要购买专用高性能盘(如 io2/gp3 高配),额外附加的 IOPS 预置费用每月动辄数百甚至上千美元。
- 单机集成度极高:通过单台 16核/128G/2.3TB NVMe 规格支撑起关键数据库,无需将架构拆碎为多台小规格机器,极大地降低了分布式运维的复杂度和网络故障点。
生产环境运维注意事项与最佳实践#
为了发挥这套硬件的全部威力,在实际落地时建议遵循以下原则:
[!IMPORTANT] 本地直通存储的高可用设计: 宿主机直连 NVMe 的生命周期与宿主机硬件紧密绑定,虽然换来了极致速度,但在极端硬件故障下不具备跨宿主机的自动数据漂移特性。因此,严禁在生产中将其作为无备份的单点运行。请务必配置主从复制(如 PostgreSQL 流复制、MongoDB Replica Set),或借助 DigitalOcean 的自动快照备份机制构建防灾冗余。
- 计费管理:由于物理 CPU、内存与宿主机 NVMe 资源在创建后即被专属锁定,即使在控制台执行关机操作(Powered Off),计费仍将持续。若临时下线不再使用,必须执行 Destroy 操作才能停止扣费。
- 私网通信利用:同一团队在同一数据中心内,Droplet 之间通过 VPC 私网进行数据同步完全免费且不消耗 8000 GiB 的公网流量池,跨节点复制应全量走 VPC 内部通道。
如需部署高可靠、无延迟抖动的高性能数据引擎,可直接在控制台调取此规格启动集群: 👉 前往 DigitalOcean 控制台选购配置