DigitalOcean 2核16G 存储优化型 Droplet 评测:为何 300GB 直连 NVMe 是低延迟数据库的黄金起点
内容更新
在云端运行数据库或高频写入服务时,很多团队最先撞上的瓶颈往往不是 CPU 算力不足,而是存储 I/O 的延迟抖动。普通的通用型云服务器大多采用网络挂载块存储(Network-Attached Block Storage),即便标称吞吐再高,数据包在宿主机与存储集群之间来回往返的网络开销也无法避免。遇到高并发写入或复杂索引扫描时,I/O Wait 飙升、事务队列堆积便成了家常便饭。
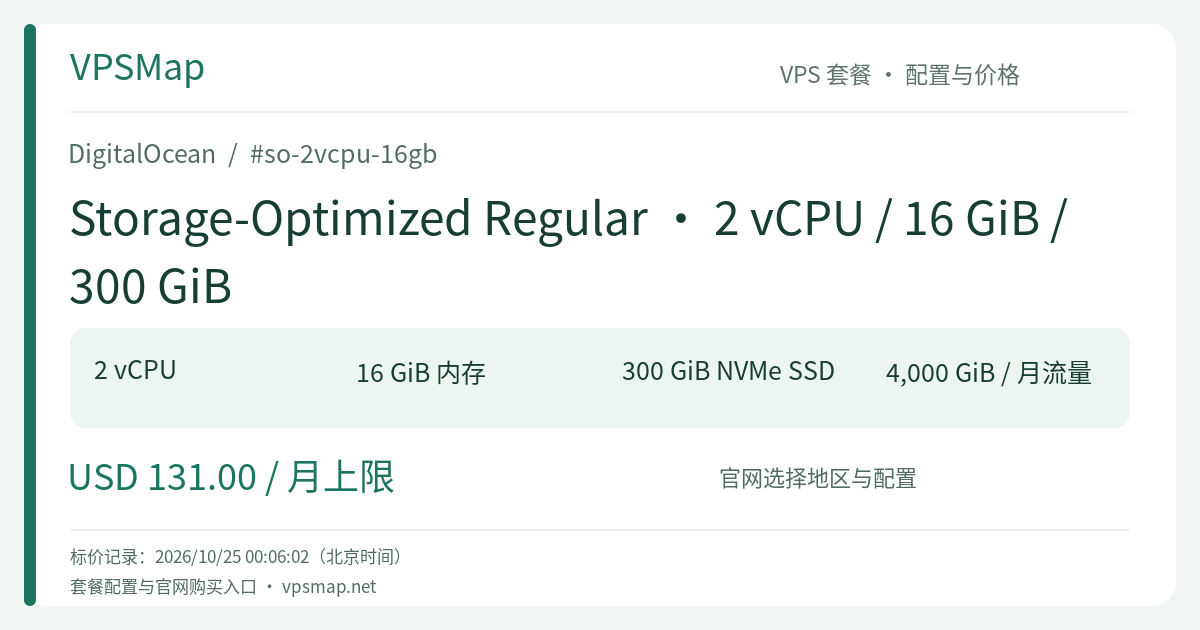
DigitalOcean 的 Storage-Optimized Regular · 2 vCPU / 16 GiB / 300 GiB(型号 so-2vcpu-16gb)正是为了彻底根治这个痛点而生。它将 300 GiB NVMe 固态硬盘直接部署在宿主机物理总线上,配合 100% 独享的计算核心与宽裕的内存配比,为对读写延迟极其敏感的业务提供了一个门槛极高却极具性价比的坚实底座。
为什么选择物理机直连 NVMe?#
要理解这台 Droplet 的价值,核心在于认清直连 NVMe 与 网络云硬盘(Volumes) 在物理架构上的本质差异:
- 物理直连 vs 网络封装:常规的云块存储走的是内部数据中心网络,无论网络多么通畅,每次读写都需要经历网络协议封装、交换机转发和存储节点响应。而存储优化型 Droplet 的 NVMe 存储直接插在宿主机总线上,借助 NVMe 协议高度并发的队列机制,数据访问延迟从数毫秒直接压低至微秒级。
- 抗 I/O 尖峰的稳健表现:对于每秒需要频繁执行
fsync刷盘的数据库(如 PostgreSQL 的 WAL 日志写入、MySQL 的 Redo Log),微秒级的直连响应能让并发事务的提交耗时大幅缩短,彻底杜绝 I/O 堵塞引发的级联延迟。 - 本地高并发 IOPS:官方资料明确指出,直连 NVMe 的并行读写特性可带来相比普通 SSD 成倍提升的吞吐性能。无需额外购买昂贵的预配置 IOPS 卷,主机本身就自带强悍的物理读写能力。
2核独享算力 + 8:1 内存配比的工程优势#
除了底层存储介质的优势,so-2vcpu-16gb 的计算架构同样遵循了严苛的生产级设计准则:
1. 真正的独享 vCPU,拒绝“邻居干扰”#
在入门级共享型实例(Basic Droplet)中,多个虚拟机共享同一物理超线程,邻居租户的瞬时压力可能导致你的任务被抢占算力。而本套餐采用的是 Dedicated vCPU,2 个核心享有专属的物理硬件超线程,无论何时运行复杂的数据库复杂联表查询或后台数据压缩,都能跑出完全一致的执行耗时。
2. 8:1 内存核心比:让系统缓存发挥极致威力#
很多开发者会疑惑:2 个 CPU 核心为什么要搭配高达 16 GiB 的内存?这恰恰是专业数据节点的精髓所在。在 Linux 系统下,内存不仅供应用程序进程使用,多余的内存全部会被操作系统自动用作 Page Cache(页面缓存):
- 数据库缓存层:以 MySQL/PostgreSQL 为例,16 GiB 内存足以划分 8~10 GiB 作为缓冲池(Buffer Pool / Shared Buffers),将高频访问的热点索引与数据页全部锁在内存中。
- 写缓冲与读加速:未命中的随机读请求由直连 NVMe 瞬间补位,而后台刷脏页的写入压力则被高吞吐 NVMe 迅速消化,形成“内存极速应答 + 本地高速落盘”的完美闭环。
适合哪些核心业务场景?#
- 单节点核心生产数据库(PostgreSQL / MySQL):数据体量在 50~200 GB 之间,日常并发请求密集,对单次查询与写入响应时间有硬性要求的在线业务主库。
- 轻量级搜索与日志中心(Elasticsearch / OpenSearch):分配 8 GiB 堆内存(Heap),保留 8 GiB 给 Lucene 系统的文件缓存,300 GiB 本地 NVMe 能够极为顺畅地应对持续的高吞吐日志写入与实时聚合检索。
- 监控与时序数据中枢(Prometheus / VictoriaMetrics):承接几十上百个节点的高频指标采集,TSDB 数据在内存压缩后高速持久化到磁盘,大幅减轻查询监控大盘时的磁盘等待。
- 高吞吐持久化消息队列(Kafka / RabbitMQ / Redpanda):需要频繁刷写磁盘日志并确保极低消息确认延迟的流处理节点。
规格全景与成本效益核算#
| 维度 | 规格详情 | 生产级价值 |
|---|---|---|
| 计算核心 | 2 vCPU(Dedicated 独享) | 杜绝邻居 CPU 争抢,保障高负载下计算稳定性 |
| 运行内存 | 16 GiB RAM(8 GiB/vCPU) | 支撑大型缓冲池与充分的系统 Page Cache |
| 本地存储 | 300 GiB 直连 NVMe SSD | 宿主机总线直连,超低读写延迟与强劲并发 IOPS |
| 内网与公网端口 | 2000 Mbps(2 Gbps) | 极速响应公网流量,私网互联快速备份 |
| 免费出网流量 | 4000 GiB / 月(团队池累加) | 入站流量全免,超出部分仅 $0.01/GiB |
| 计费封顶机制 | 672 小时 / 月封顶 | 按秒计费(满 60 秒起),随建随用,预算完全可控 |
网络计费提示:DigitalOcean 的流量机制非常友好,所有入站流量完全免费,且 4000 GiB 的出网配额会按团队维度汇入流量池(Team Transfer Pool)。如果同账号下其他机器流量超标,本机器充裕的额度可以直接跨实例冲抵。
生产运维不可忽视的必要取舍#
选择本地直连 NVMe,享受了极致性能的同时,必须理解其物理特性带来的架构约束:
- 存储与物理宿主机绑定:由于 NVMe 磁盘位于特定宿主机内部,如果底层物理硬件出现不可恢复的异常,无法像网络卷那样“一键解挂并立即挂载到备用机器”。
- 容灾必须从架构层做起:
- 开启自动备份:强烈建议在控制台开启 DigitalOcean Backups(每周备份仅增加 20% 费用,每日备份增加 30% 费用),系统会自动对整机做增量磁盘镜像备份。
- 主从热备或异地转储:关键生产库应当配置 Master-Replica 复制,或者通过定时任务将物理备份(如 pg_dump / mysqldump)通过内网传输到 DigitalOcean Spaces 对象存储中(同可用区走私网解析不计公网流量费)。
- 关机依然计费:由于 Dedicated CPU 和本地 NVMe 资源在宿主机上受到持续独占保留,Droplet 处于关机(Powered Off)状态时仍然会继续计费。若彻底不再使用,必须在控制台中执行“Destroy(销毁)”操作。
总结与选购建议#
如果你的服务正在遭受偶发性慢查询困扰,且监控排查发现大量的 CPU 时间浪费在 I/O 等待上,那么将应用迁移到 Storage-Optimized 2 vCPU / 16 GiB 就是立竿见影的破局手段。它以极其纯粹的硬件堆料——独享双核、16GB 充沛内存与 300GB 直连 NVMe,为中小型关键负载打造了一座稳如磐石的低延迟堡垒。
请注意:各数据中心的存储优化型硬件库存以控制台即时创建页面为准。