DigitalOcean 384GB 内存型旗舰 Droplet 深度评测:48 核独享算力与 10Gbps 骨干网络,化解大型数据库与重型 JVM 性能瓶颈
内容更新
为什么需要一台 384 GiB 内存的云服务器?#
在现代后端与分布式架构中,系统最致命的短板往往不是 CPU 峰值算力,而是内存耗尽(OOM)引发的级联崩溃,或是工作集超出物理内存后频繁陷入磁盘换页(Swap Thrashing)导致的响应延迟断崖式暴跌。
当单机承载的 Redis 缓存集群、Elasticsearch 聚合检索节点、Kafka 消息队列,或者 PostgreSQL / MySQL 核心数据库的活动数据集膨胀到数百吉字节时,分布式分片虽然能横向扩容,但分片带来的分布式事务管理、跨节点网络开销、故障转移复杂度和运维人力成本都会呈指数级上升。
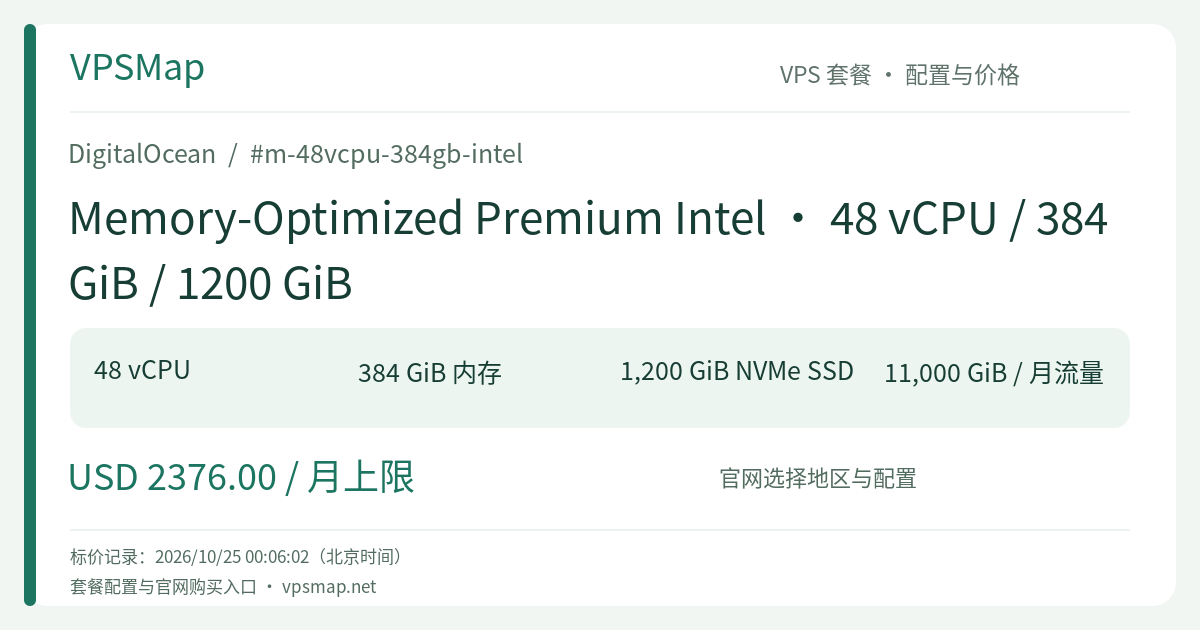
DigitalOcean 的 m-48vcpu-384gb-intel(Memory-Optimized Premium Intel)正是为了解决这种极端“内存饥渴型”核心负载而设计的单机巨型节点。它通过 48 颗 100% 独享硬件超线程、384 GiB 物理内存(严格保持 8:1 的内存核心比)、1,200 GiB 直连 NVMe 固态硬盘 以及 高达 10 Gbps 的网络吞吐接口,为关键业务构筑了一座性能稳固、杜绝资源争抢的计算底座。
硬件架构与硬核指标解析#
与入门级共享型(Basic)Droplet 允许物理核心超卖并按需动态分发周期的机制完全不同,该机型属于 Dedicated CPU 系列,底层硬件与虚拟化策略具备极高的工业级确定性:
1. 独占超线程与第三代英特尔至强可扩展处理器#
- 100% 专属计算能力:分配给 Droplet 的 48 个 vCPU 分别对应宿主服务器物理处理器上的真实硬件超线程(Hyper-Thread)。无论宿主机上其他租户运行何种批处理任务,均无法挤占或削弱你的 CPU 时钟周期。
- 高频内存总线:Premium Intel 配置搭载第三代 Intel Xeon Scalable 处理器,配备 2,933 MHz 高频内存。对于密集型内存扫描、哈希表查找和列式聚合运算,高频带宽能显著降低指令周期的等待时间。
2. 10 Gbps 超高网络吞吐能力#
普通常规 CPU Droplet 的网络接口通常维持在基础带宽水平,而 Premium 系列 Droplet 拥有最高 10 Gbps 的网络吞吐能力,数据导出与内部同步速度最高可达常规实例的 5 倍。当单节点承载近 400 GB 内存并需要进行内存快照同步、跨可用区数据复制或高吞吐数据摄入时,10 Gbps 管道能彻底消除网卡跑满引起的网络拥塞与心跳丢失。
3. 高并行度直连 NVMe SSD#
配备 1,200 GiB 本地 NVMe 固态硬盘。与通过网络协议挂载的云硬盘(Block Storage Volumes)不同,本地 NVMe 直接挂载在宿主机总线上,利用高度并行的 NVMe 队列协议,提供极低延迟的寻址与高速读写,天然适配高频刷盘的预写式日志(WAL)、事务日志和重型日志抓取。
核心适用业务场景#
这台规格顶级的 Droplet 并不是为通用低负载网站准备的,但在以下四个专业领域,它是投入产出比极高的架构选择:
1. 超大规模内存缓存(Redis / KeyDB / Dragonfly)#
将数十个碎片化的中小型缓存实例聚合到一台或主备两台配备 384 GiB 内存的节点上,可以大幅简化连接池管理和 Sentinel / Cluster 拓扑结构。384 GiB 的充裕空间允许将上亿条复杂的业务对象、热点 Session 和实时排行榜常驻内存,从根本上终结后端数据库的穿透危机。
2. 重型 JVM 应用与全文检索(Elasticsearch / OpenSearch)#
Java 运行时环境在处理大规模数据时对内存有双重需求:不仅 JVM Heap 需要足够的空间存放索引对象与缓存以支撑复杂聚合查询,底层操作系统更需要庞大的 Page Cache 来缓存 Lucene 索引段。48 核算力搭配 384 GiB 内存,允许分配合理的堆内存空间(如 31 GB 避开指针压缩失效),并将剩余超过 300 GiB 的物理内存全部留给系统文件缓存,使搜索响应时间稳定维持在亚秒级。
3. 核心关系型数据库(PostgreSQL / MySQL InnoDB)#
许多中大型业务在数据库容量达到数百 GB 时性能急剧下降,核心原因就是缓冲池(Buffer Pool)无法装下全部热数据,导致频繁产生物理磁盘 I/O。在 384 GiB 内存环境下,你可以直接将 PostgreSQL 的 shared_buffers 或 MySQL 的 innodb_buffer_pool_size 调整到 250 GiB 以上,实现“全热数据在内存中命中”,TPS(每秒事务数)可实现成倍跃升,而 1,200 GiB 本地 NVMe 则充当稳固的高速事务日志与表空间存储。
4. 实时分布式数据流与计算引擎(Kafka / ClickHouse / Trino)#
作为 Kafka Broker,384 GiB 内存能提供海量的 Linux Page Cache,确保生产端与消费端绝大多数读写直接发生在操作系统缓存层,免去落盘反查开销;结合 10 Gbps 网络端口,可轻松吞吐几十万每秒的消息流。
成本核算与网络计费优势#
对于月预算超过两千美元的核心服务器,清晰可预测的账单规则至关重要:
| 计费维度 | 规则与核算说明 |
|---|---|
| 计费粒度 | 按秒计费(创建至少计费 60 秒或 $0.01),弹性极高,按需开启测试或跑批极为经济 |
| 月度封顶上限 | 每月封顶计费 672 小时(28 天),超出 672 小时的时间不再额外加收计算费用 |
| 内含出网流量 | 标配高达 11,000 GiB(11 TB) 免费出网流量 |
| 流量计费机制 | 团队级别合并流量池(Pooled Bandwidth):同一团队下所有 Droplet 贡献的额度累加计算;超额流量每 GiB 仅收取 $0.01;所有入网流量(Inbound)完全免费 |
| 内网通信成本 | 通过 VPC 私网地址在同一数据中心内进行的数据交互完全免费,且不扣减出网额度 |
运维提示:根据官方计费策略,处于关机(Power Off)状态的 Droplet 依然会持续占用宿主机的专用 CPU、内存与磁盘资源,因此关机状态仍会继续计费。如仅用于临时批处理,任务完成后需通过控制台或 API 彻底执行销毁(Destroy)以停止账单计费。
架构规划与选型建议#
- 存储扩展路径:本方案自带的 1,200 GiB NVMe 为宿主机直接挂载,用于操作系统、运行环境及核心热数据。如果业务伴随冷数据、历史文件或备份归档,建议配合挂载 DigitalOcean Volumes 块存储,或通过 VPC 内网接入 Spaces 对象存储(同可用区经由 VPC 内网解析不消耗公网流量配额),实现热冷数据分层。
- 数据安全与备份:生产环境建议在创建时启用自动化系统快照(Backups)。每周备份费用仅为 Droplet 费用的 20%,支持按时间点快速创建镜像或克隆恢复。
- 容量确认:此类 48 核独享型大内存配置在各大洲机房受物理机位制约,控制台展示价格并不代表绝对永久现货,建议尽早登录控制台确认目标可用区(如 SFO3、NYC3、FRA1、SGP1)的实时可用容量。