DigitalOcean 存储优化型旗舰:48核 384GB 与 7TB 直连 NVMe 的极致性能之选
内容更新
在云计算架构设计中,许多团队都经历过相似的性能死锁:CPU 利用率尚有余量,内存也未耗尽,但数据库响应时间却剧烈抖动,iowait 持续飙升。根本原因通常在于存储链路的延迟与吞吐天花板——即便采用了云厂商的高性能网络云盘,跨网络的虚拟化 I/O 依然难以支撑数十万次甚至上百万次高频随机读写。
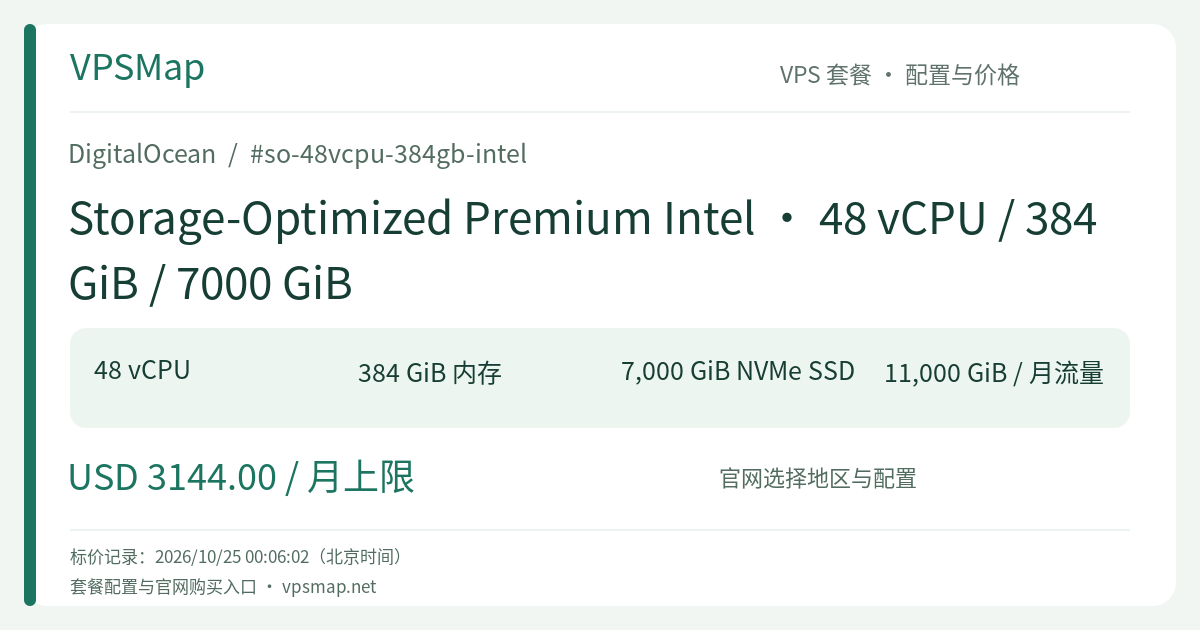
针对这种对 I/O 延迟零容忍、数据吞吐要求严苛的生产场景,DigitalOcean 推出了其存储优化型阵容中的最高规格配置:Storage-Optimized Premium Intel · 48 vCPU / 384 GiB / 7,000 GiB (型号 so-48vcpu-384gb-intel)。这不仅是一台单体算力怪兽,更是为吞吐敏感型中枢系统量身定制的高速基建。
核心优势:为什么宿主机直连 NVMe 是不可替代的?#
大多数常规云主机依赖网络块存储(如 Volumes / EBS)。在常规 Web 应用下这种架构灵活且支持任意解绑,但在超重载有状态系统下,网络通信包封装、交换机跳数以及云盘 QoS 限制都会成为吞吐阻碍。
so-48vcpu-384gb-intel 的核心价值在于其 7,000 GiB(7 TB)物理直连 NVMe SSD:
- 微秒级物理总线延迟:存储直接挂载在宿主机底层物理主板的 PCIe 总线上,绕过虚拟网络层。无论是高频更新的 WAL(预写日志),还是密集的随机 Page Read,延迟都压低在微秒级。
- 硬件级高并行队列:NVMe 协议专为现代固态硬盘的并行特性设计,原生支持多队列调度。配合 48 颗专属物理超线程,系统可以并发处理海量 I/O 请求而不会产生 I/O 队列拥塞。
- 释放 CPU 真实算力:没有了因等待网络块存储返回而产生的阻塞中断,48 颗专属 CPU 核心可以持续满负荷运转在计算与索引构建上,真正榨干每一分算力价值。
硬件协同:48 核心、384 GiB 内存与 10 Gbps 高速通道#
除了庞大的本地存储,这套配置在计算与网络配比上也极为考究:
- 第三代 Intel Xeon Scalable 专用核心
属于独占算力体系(Dedicated CPU),每个 vCPU 严格绑定宿主机物理超线程,彻底杜绝邻居资源争抢(No Steal Time)。Premium Intel 版本拥有出色的单核睿频表现,并具备 AVX-512 等指令集加速能力,对大规模向量计算、JSON 序列化与数据压缩尤为友好。 - 384 GiB 大容量内存(8:1 内存/核心黄金比)
为高负载数据库提供了极其宽裕的内存缓存空间。在 PostgreSQL 或 MySQL 中,你可以将shared_buffers和 OS Page Cache 调大至数百 GB,实现大部分热数据直接命中内存;对于 Elasticsearch 或 ClickHouse,大内存意味着充足的 JVM 堆空间与底层的 Lucene 内存映射区。 - 高达 10 Gbps 的 Premium 网络吞吐
不同于普通机型的基础网络带宽,Premium Intel 机型享有高达 10 Gbps 的网络输出能力。无论是执行多副本跨节点同步、集群重平衡(Rebalance),还是分发数十吉字节的数据快照,都能以数倍于常规网络的速度在短时间内完成,显著降低集群复制延迟。
哪些生产工作量非它莫属?#
这台配置专为单机吞吐要求极高的核心业务设计:
1. 分布式检索与时序引擎(Elasticsearch / OpenSearch / ClickHouse)#
在日志归集、可观测性监控平台或安全信息事件管理(SIEM)系统中,每天数以亿计的事件流涌入。作为热数据存储节点,7 TB 本地 NVMe 能够直接承载超大规模热分片,结合 384 GiB 内存,让海量聚合与复杂 DSL 查询在秒级甚至亚秒级返回,彻底告别查询超时。
2. 超高并发写入的 NoSQL 与关系型中枢(MongoDB / PostgreSQL)#
在大型电商促销、金融对账或物联网(IoT)设备数据上报场景中,写入吞吐是首要考量。本地 NVMe 彻底消除 WAL 写入等待,384 GiB 内存让 B-Tree / LSM-Tree 结构始终保持最佳读写状态。
3. 大吞吐事件流代理(Apache Kafka / Redpanda)#
Kafka 极其依赖操作系统的 Page Cache 和顺序磁盘 I/O。在此机型上,10 Gbps 网卡保障了超宽的数据摄入通道,NVMe 磁盘则保证在多分区落盘时无缝吞吐,轻松承载数十万 TPS 的持续消息洪峰。
生产架构设计与必要取舍#
选择本地存储优化型服务器,需要团队具备清晰的架构容灾意识:
- 本地盘单点失效考量:由于 7 TB 空间为宿主机直连存储,若宿主机发生物理硬件故障,无法像网络云盘那样一键无损漂移到另一台机器。必须通过应用层多副本架构保障容灾。例如,搭建 3 节点 MongoDB Replica Set、ClickHouse 跨节点副本表或 Kafka 多副本 ISR 机制,让硬件故障由分布式集群自我修复。
- 备份策略规划:利用 DigitalOcean 控制台内建的自动化快照(Backups)或 SnapShooter 工具定期生成全量/增量系统镜像;对于核心应用数据,应定期通过内部 VPC 通道快速同步至 Spaces 对象存储,兼顾吞吐与持久性。
- 流量与私有网络协同:该机型自带 11,000 GiB(11 TB)团队级月度出站流量,入站完全免费。集群内部节点间的数据通信务必走 VPC 私网(内网通信免费且享有超低延迟),将高昂的外网流量池留给核心 API 出口。
成本模型与按需伸缩价值#
对于这样一台企业级配置,DigitalOcean 的计费机制提供了极高的财务弹性:
- 秒级计费与 672 小时封顶:月度计费上限为 672 小时(28 天),达到上限后当月剩余天数不再计费。按小时计费模式下仅为约 $4.68/小时。这意味着你无需签订 1~3 年的沉重商业长约,即可临时拉起一台进行为期 3 天的千万级压力测试、数据清洗迁移或季度财务清算任务,任务完成后随时销毁,成本完全可控。
- 库存核实建议:由于 48 核心配搭 7 TB 本地 NVMe 属于机房核心大件物理资源,各可用区(如 NYC1、AMS3、FRA1、SGP1)的实时物理余量可能有所波动。建议在正式架构部署前,通过 DigitalOcean 控制台 实际确认目标机房的即时容量与配额状态。
快速启动示例#
你既可以通过 Web 控制台在「Storage-Optimized」栏目下选择该规格,也可以直接通过官方 CLI 工具 doctl 快速下发创建指令:
# 查看当前可用区内该规格状态
doctl compute size list | grep so-48vcpu-384gb-intel

# 在指定机房(如 fra1)一键启动旗舰存储节点
doctl compute droplet create db-master-01 \
  --region fra1 \
  --image ubuntu-24-04-x64 \
  --size so-48vcpu-384gb-intel \
  --enable-monitoring \
  --enable-private-networking \
  --ssh-keys <YOUR_SSH_KEY_FINGERPRINT>
如果你的核心基础设施正在遭遇存储瓶颈,或者正准备支撑下一阶段百倍级的数据体量,这台兼具极速本地 I/O 与充沛算力的旗舰机型,将是你在云端最坚固的地基。