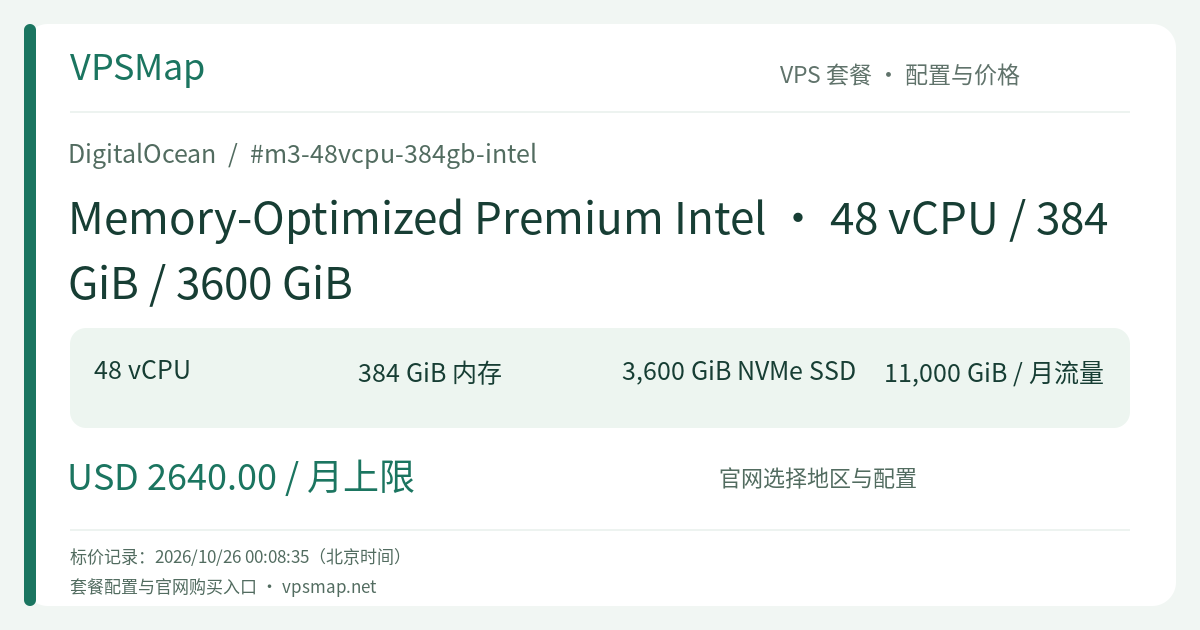
DigitalOcean 3.6TB NVMe 巨量存储与 384GB 内存旗舰 Droplet:48 核独享算力的高 IOPS 重型数据底座
内容更新
为什么在 384 GiB 内存的基础上,还需要 3,600 GiB 本地 NVMe?#
在规划高负载后端架构时,许多技术团队经常面临两难抉择:是将业务数据托管在带有大量内存的计算节点上,依靠网络挂载云硬盘(Block Storage Volumes)提供存储?还是采用纯物理直连存储?
网络云硬盘虽然具备出色的弹性与快照便利性,但在处理极端的高并发随机 I/O、复杂 OLAP 列式扫描、时序数据高频写入或百亿级向量相似度检索时,网络协议栈不可避免地会引入数毫秒的通信开销与 IOPS 瓶颈。
DigitalOcean 的 m3-48vcpu-384gb-intel(属于 Storage-Enhanced 内存优化系列)以极具性价比的配置打破了这一妥协:
- 48 颗 100% 独享硬件核心(Premium Intel 第三代至强可扩展处理器);
- 384 GiB 物理内存,满足最苛刻的内存数据库与巨大索引缓存需求;
- 3,600 GiB(3.6 TB)直接挂载于物理机宿主机的高速 NVMe 固态硬盘;
- 最高 10 Gbps 的物理骨干网络吞吐能力。
相比标准内存型的 1,200 GiB 本地盘,该型号将直连 NVMe 容量整整翻了三倍,彻底消除了数据持久化与超高 IOPS 吞吐之间的鸿沟。
投资回报率:仅需 11% 的边际成本,换取 300% 的超高速存储空间#
评估这款机型时,最直观的决策维度在于边际溢价与生产收益的对比:
| 方案对比 | 标准款 (m-48vcpu-384gb-intel) | 扩展存储款 (m3-48vcpu-384gb-intel) | 差异优势 |
|---|---|---|---|
| 独享计算核心 | 48 vCPU (Dedicated Premium Intel) | 48 vCPU (Dedicated Premium Intel) | 一致保证,无任何超卖 |
| 物理内存 | 384 GiB (2,933 MHz) | 384 GiB (2,933 MHz) | 一致保证,8:1 黄金配比 |
| 本地直连 NVMe | 1,200 GiB | 3,600 GiB (3.6 TB) | 净增 2,400 GiB 高速 NVMe(提升 200%) |
| 网络吞吐能力 | 最高 10 Gbps | 最高 10 Gbps | 支持海量数据并行同步 |
| 出网流量配额 | 11,000 GiB(团队共享池) | 11,000 GiB(团队共享池) | 超出部分仅 $0.01/GiB |
| 月度封顶价格 | $2,376.00 / 月 | $2,640.00 / 月 | 月成本仅增加 $264.00(涨幅约 11.1%) |
如果尝试在标准款上通过网络挂载 2,400 GiB 的常规网络块存储,不仅要额外承担存储费用,而且吞吐量与微秒级延迟表现根本无法与直插宿主机 PCIe 通道的物理 NVMe 阵列相媲美。仅需微幅增加预算,就能让节点直接拥有 3.6 TB 的原生极速读写盘,这是处理高吞吐重型数据层极具吸引力的升级理由。
专为这四类“大内存 + 大吞吐”工作负载而生#
1. 海量分析型列式与时序数据库(ClickHouse / TimescaleDB)#
ClickHouse 和 TimescaleDB 在执行复杂宽表聚合查询时,不仅需要海量内存作为排序、哈希表构建与中间计算池,更依赖超高的局部磁盘读取带宽以秒级扫描数亿行数据。3.6 TB 的本地 NVMe 配合 384 GiB 内存,可以让单台节点独立承担百亿级日志与指标数据的实时计算,无需提早引入复杂的分布式 ClickHouse 集群。
2. 分布式 NoSQL 核心节点(Apache Cassandra / ScyllaDB / MongoDB)#
像 Cassandra 或 ScyllaDB 这类高度依赖本地 LSM-Tree 存储引擎的分布式数据库,其核心性能取决于内存 Memtable 刷新与磁盘 SSTable 合并(Compaction)的吞吐能力。3.6 TB 的超低延迟 NVMe 能杜绝 Compaction 积压导致的写入停顿;同时 48 核独享计算力保证了多线程并发查询的稳定性。
3. 百亿级向量检索与多模态大模型数据底盘(Milvus / Qdrant)#
高维向量索引(如 HNSW)对内存消耗极大,一旦全量向量超出内存容量,就必须利用 MMAP 或量化技术(PQ/SQ)将温冷向量置于磁盘。在普通存储上,磁盘向量检索延迟会飙升数十倍。而在 3,600 GiB 高速 NVMe 上,结合 384 GiB 物理内存,可以在亚毫秒级内完成大规模向量的混合磁盘召回,为 AI 知识库与生成式搜索提供澎湃底盘。
4. 消除分布式分片的大型一体化 PostgreSQL / MySQL 数据库#
许多企业在单表突破数千万、总库体量达到 1~2 TB 时过早考虑分库分表,从而付出了巨大的研发重构代价。采用 m3 架构,可以将 2 TB+ 的整个核心生产库直接完整装载在单台主库中:数百 GiB 内存锁定活动索引与热页,3.6 TB 本地 NVMe 轻松吃下全部物理表空间与持续生成的 WAL 日志,单机稳定支撑每秒数万事务,系统架构极其纯粹优雅。
网络互通与费用透明度#
- 11,000 GiB 团队流量池:标配 11,000 GiB 免费公网流出带宽。在 DigitalOcean 的计费机制中,流量是在团队级别(Team Level)按月自动合并池化的。如果团队中同时运行其他轻流量 Droplet,闲置带宽会自动贴补给这台重型节点。出网超出部分按全球统一的 $0.01/GiB 超低阶梯计费,入网流量全免。
- 10 Gbps 骨干连接与免费 VPC:多节点间通过私有网络(VPC)互联时,内网流量完全免费且不消耗公网额度。10 Gbps 的大口径管道让数据库的主从全量数据同步与备份能够在数十分钟内闪电完成。
- 按秒计费与 672 小时保护:支持灵活的秒级计费(最小周期 60 秒),每月计费时间封顶为 672 小时(28 天)。这意味着在一个持续运行的自然月中,无论当月是 30 天还是 31 天,计算费用都不会超出封顶线。
部署最佳实践与运维须知#
- 数据备份安全规范:由于 3.6 TB NVMe 属于宿主机本地直接挂载存储,具备极致性能的同时,容灾规划必不可少。建议结合使用每日/每周自动快照功能(Backups),并配合应用层的主从双机热备(如 PG 流复制或 MySQL Group Replication),确保数据高可用。
- 停机扣费规则:切记在控制台执行“关机(Power Off)”并不会停止计费,因为 48 核心、384 GiB 内存以及整整 3.6 TB 的物理 NVMe 依然被 Hypervisor 严格保留。只有不再需要该服务器并执行“销毁(Destroy)”后,账单才会终止。
- 即时库存核实:3.6 TB NVMe + 384 GiB 属于稀缺的高密度物理资源,仅在特定骨干数据中心部署。公开价格不代表所有机房随时有充裕现货,建议直接进入管理面板验证目标区域(如 SFO3、NYC3、FRA1、AMS3)的现货配额。