
Qué hacer primero durante los picos de CPU: distinguir entre ráfagas, carga sostenida y límites del panel#
Al iniciar sesión en su VPS y notar un aumento repentino de CPU, evite apresurarse a reiniciar el servidor o gastar dinero en actualizaciones de planes. Su primer paso siempre debe ser determinar la naturaleza exacta de la carga de trabajo: ¿se trata de una ráfaga intermitente que ocurre cada pocos minutos o de una cola sostenida provocada por una acumulación importante de tareas de la aplicación?
Según los Términos de Servicio oficiales, BandwagonHost separa las ráfagas breves de CPU de la asignación de CPU promedio de una hora en planes sin SLA, con límites específicos determinados por el nombre completo del plan. Esto significa que alcanzar brevemente una utilización de CPU de 100% no constituye intrínsecamente una infracción de la política. Solo cuando el consumo promedio de una hora supera de forma constante la cuota de su plan, el hipervisor subyacente limitará los ciclos de CPU disponibles. Durante la limitación, su VPS sigue funcionando y aparece una alerta en el panel de control de KiwiVM; una vez que la utilización promedio vuelve a estar dentro de los límites permitidos, las restricciones de CPU se levantan automáticamente. Los términos oficiales no garantizan que los límites se eliminen de inmediato o en una cantidad determinada de minutos, ni se debe considerar una sola instantánea de utilización completa de la CPU como prueba de la aplicación de la política.
Observe simultáneamente el rendimiento real de las aplicaciones. Si sus sitios web y respuestas de API siguen respondiendo por completo, las páginas se cargan sin colas de tiempo de espera y el panel de KiwiVM no muestra advertencias de CPU, los picos breves generalmente tienen un impacto mínimo en la experiencia del visitante.
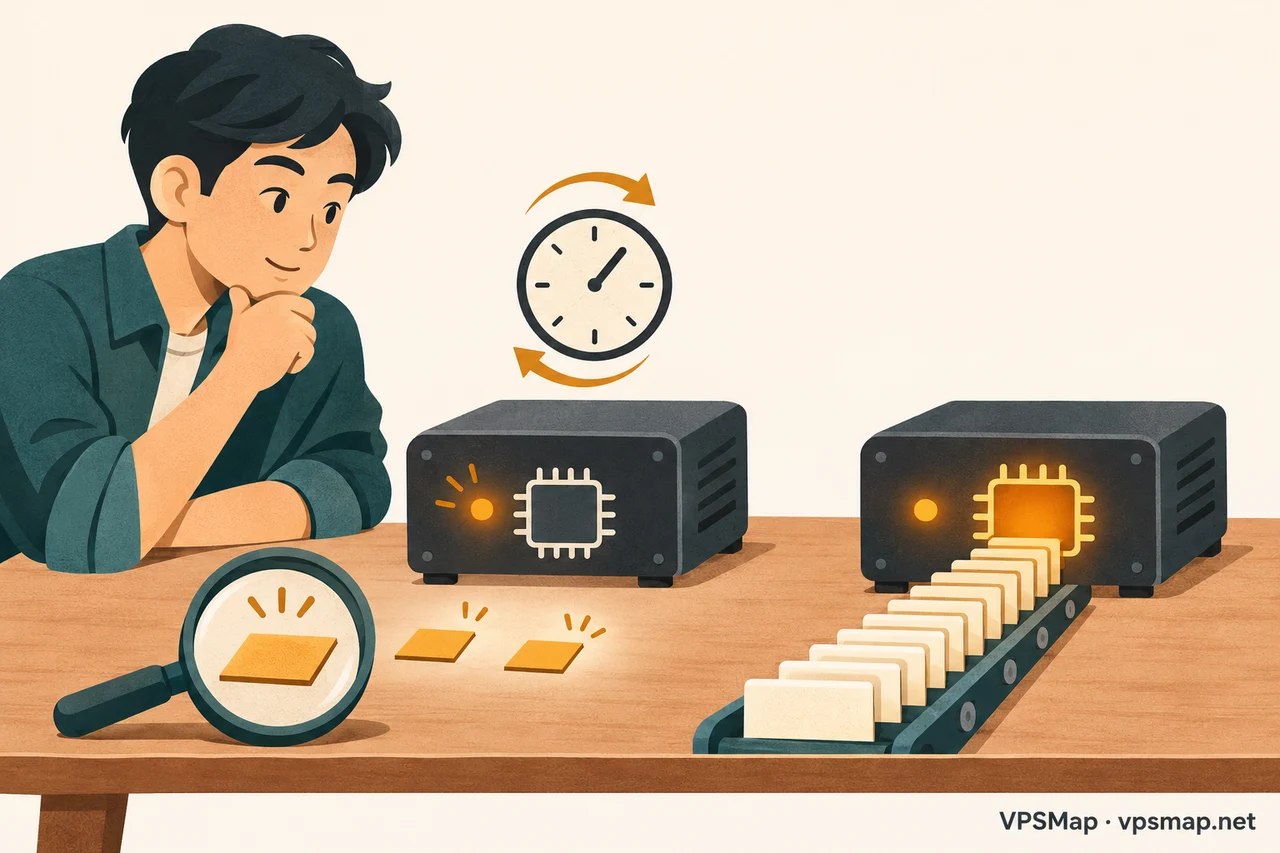
Comprender el contraste entre estos escenarios ayuda a evitar gastos innecesarios en infraestructura:
- Picos breves y repetidos: la CPU aumenta brevemente durante varios segundos a intervalos regulares antes de descender rápidamente, lo que deja el sistema prácticamente inactivo con una entrega de tráfico normal.
- Colas de sobrecarga sostenida: la CPU permanece constantemente elevada, el consumo promedio durante una hora supera los umbrales del plan, se activan advertencias en el panel y las solicitudes públicas sufren retrasos.
Observación continua y captura de PID con herramientas de Linux de solo lectura#
Una vez que se considere necesaria una investigación, recopile datos de diagnóstico dentro del sistema operativo mediante herramientas seguras y de solo lectura, sin modificar ninguna configuración del sistema ni los servicios en ejecución.
Comience con un breve período de observación utilizando top en modo por lotes:
top -b -d 2 -n 6Este comando captura 6 iteraciones a intervalos de 2 segundos, generando su primera salida de inmediato sin demora inicial. Esta breve ventana le permite supervisar PID, COMMAND, %CPU y el ritmo de ejecución. Tenga en cuenta que los procesos de corta duración o intermitentes pueden aparecer y finalizar entre intervalos de muestreo; no capturar actividad en una muestra no descarta su existencia. Este comando se aplica a entornos Linux equipados con procps; consulte la documentación del paquete de su distribución si la herramienta no está presente.
Para capturar una instantánea amplia de la tabla de procesos, use ps para revisar las primeras líneas de la lista ordenada:
ps -eo pid,ppid,comm,pcpu,pmem --sort=-pcpu | head -n 16Dado que head -n 16 incluye el encabezado de la tabla, muestra las primeras filas de la salida. Tenga en cuenta la métrica de informe exacta: %CPU (o pcpu) en ps representa la proporción del tiempo de CPU durante toda la vida útil respecto al tiempo total de ejecución transcurrido del proceso. No es una muestra instantánea en tiempo real de 2 segundos ni la métrica de facturación de una hora del proveedor. Al ordenar por pcpu, los procesos se ordenan por su promedio histórico y no por picos momentáneos en tiempo real. El uso de comm muestra los nombres de los ejecutables sin los argumentos completos de la línea de comandos, lo que reduce la exposición de credenciales o tokens confidenciales, aunque las salidas aún deben depurarse antes de compartirse.
Tras identificar un PID candidato, inspeccione su duración de ejecución y los detalles del proceso principal mediante estas dos consultas:
ps -p PID -o pid,ppid,comm,etimes,pcpu,pmemps -p PARENT_PID -o pid,ppid,commReemplace siempre los marcadores de posición PID y PARENT_PID por los valores numéricos observados reales. Los procesos efímeros pueden finalizar rápidamente y Linux reutiliza los valores de PID, por lo que debe verificar que el proceso aún se esté ejecutando antes de inspeccionarlo. El nombre del ejecutable por sí solo no demuestra el origen del software, su legitimidad o si se puede detener de forma segura; capturar la duración del tiempo de ejecución y el linaje del proceso principal proporciona la base para una resolución de problemas precisa.
Correlación de temporizadores del sistema y rastreo del origen de los procesos#
Cuando la actividad de un proceso sigue una programación estrictamente repetitiva, relacione las marcas de tiempo de los picos observados con los mecanismos de programación del sistema.
En sistemas que utilizan systemd, inspeccione las unidades de temporizador con el siguiente comando:
systemctl list-timers --all --no-pagerEsto enumera todas las unidades de temporizador cargadas actualmente en la memoria de systemd (incluidas las unidades inactivas), junto con su última hora de activación, la próxima ejecución programada y el servicio asociado. Compare estos programas con las marcas de tiempo de sus picos de CPU. Tenga en cuenta que este comando solo se aplica a entornos systemd y no revela tareas cron estándar, programaciones internas de contenedores o bucles de ejecución a nivel de aplicación; la ausencia de temporizadores coincidentes no garantiza que no exista una tarea periódica en segundo plano. Además, la coincidencia en las horas de activación proporciona indicios de diagnóstico y no una prueba definitiva de causalidad.
En cuanto a los informes de casos públicos, el usuario William Long publicó en X el 2026-11-01 describiendo breves picos de CPU que se repetían cada minuto en un entorno específico. Esto representa un informe de usuario individual aislado y no una confirmación oficial del proveedor, por lo que no debe generalizarse a todas las configuraciones operativas.
Gestione las tareas identificadas según su origen:
- Cargas de trabajo de aplicaciones de usuario: Si los picos se deben a tareas comerciales confirmadas, como exportaciones de bases de datos, reconstrucciones de caché o mantenimiento de registros, optimice la ejecución ajustando la concurrencia, implementando colas de trabajadores o trasladando las tareas a ventanas de mantenimiento con poco tráfico.
- Componentes del sistema desconocidos: Si se encuentra con un proceso desconocido o un demonio de gestión preinstalado, nunca termine procesos ni deshabilite servicios basándose en recomendaciones no verificadas de internet, ya que esto puede romper los canales de gestión de la virtualización. En su lugar, recopile registros de diagnóstico y busque orientación oficial.
Cuándo optimizar las cargas de trabajo existentes frente a considerar mejoras de plan#
La actualización de niveles de servidor nunca debe utilizarse para enmascarar procesos en segundo plano no verificados. Si un bucle de software subyacente o un servicio mal configurado provoca picos, cambiar a un plan superior simplemente consumirá capacidad de cómputo en una máquina más cara y dejará el problema sin resolver.
Las mejoras de plan solo se justifican cuando sus cargas de trabajo de producción verificadas superan de manera constante las asignaciones de hardware y el margen sostenido de CPU de una hora. Los diferentes niveles de planes de BandwagonHost se centran en distintas opciones de tránsito de red y regiones de centros de datos; elegir un nivel de red premium no resuelve los picos de cómputo.
Revise los siguientes detalles verificados del plan:
| Nombre del plan | Especificaciones de hardware | Velocidad de puerto y perfil de tránsito | Precio de referencia por el período completo | Enlace de compra verificado |
|---|---|---|---|---|
| Basic 40G / 2GB (PID 45) | 3 vCPU / 2048 MB RAM / 40 GB de almacenamiento / 2000 GB de ancho de banda mensual | Velocidad de puerto de 1000 Mbps, centro de datos de ejemplo USCA_2 | $99.99 al año (ciclo más corto semestral a $52.99) | Pedir Basic 40G anualmente |
| E-Commerce 40G / 2GB (PID 88) | 3 vCPU / 2048 MB RAM / 40 GB de almacenamiento / 2000 GB de ancho de banda mensual | Velocidad de puerto de 2500 Mbps, centro de datos de ejemplo USCA_9 | $299.99 al año (ciclo más corto trimestral a $89.99) | Pedir E-Commerce 40G anualmente |
Al evaluar estas opciones, tenga en cuenta que los precios de E-Commerce reflejan rutas de tránsito especializadas diseñadas para la conectividad de audiencias específicas, y no una mitigación para procesos anómalos. Las velocidades de puerto representan capacidades de interfaz virtual, no ancho de banda de tránsito continuo garantizado. Las opciones de facturación anual requieren el pago por adelantado del período completo en lugar de deducciones mensuales. Los ciclos de facturación y el inventario disponibles reflejan las condiciones observadas el 2026-11-03 y dependen de la disponibilidad en tiempo real durante el proceso de pago.
Para explorar niveles activos adicionales y condiciones globales, visite el Portal principal de BandwagonHost o consulte el Catálogo de planes de BandwagonHost.
Preparación de un registro de diagnóstico conciso para consultas de soporte#
BandwagonHost opera un alojamiento KVM VPS autogestionado. El proveedor gestiona el estado del nodo físico y la conectividad de red, mientras que el mantenimiento del sistema operativo, la configuración de demonios y las copias de seguridad de datos siguen siendo responsabilidad del usuario. En consecuencia, cualquier consulta dirigida al soporte oficial debe proporcionar hechos claros, concisos y de solo lectura.
Si sospecha que un proceso desconocido está vinculado a una plantilla del sistema operativo, recopile un registro de diagnóstico mínimo antes de ponerse en contacto con el soporte a través de los Canales de soporte oficiales:
- Marca de tiempo y zona horaria: Anote las marcas de tiempo exactas del pico con una indicación explícita de la zona horaria (como UTC o la desviación local).
- Impacto en producción: Indique si los servicios web o las API orientados al usuario experimentaron ralentizaciones o fallos de conexión durante el evento.
- Características del pico: Detalle la duración de la ráfaga en segundos, la frecuencia de recurrencia y si el panel de KiwiVM indicó limitaciones de CPU (throttling).
- Campos de salida del proceso: Adjunte el PID, el PID padre, el nombre del ejecutable (comm) y la duración del tiempo de ejecución recopilados mediante comandos de solo lectura.
- Detalles del entorno: Indique la distribución de Linux, la versión del kernel y el código de ubicación del centro de datos.
Antes de enviar, realice una auditoría de privacidad exhaustiva: elimine todas las claves privadas, contraseñas, tokens de API, líneas de comando completas que contengan información confidencial, registros de clientes y datos de facturación. Centre la consulta en aclarar la función asignada al componente, las versiones de plantilla aplicables y los procedimientos de mantenimiento recomendados. Los equipos de soporte no se comprometen a intervalos de respuesta específicos ni a resoluciones predefinidas.
Para consultar referencias adicionales de configuración y del panel de control, consulte la Descripción general de BandwagonHost y la Guía de la API de KiwiVM.
Documentación oficial y referencias:
- Términos de servicio de BandwagonHost
- Catálogo de productos de BandwagonHost
- Página del manual de Linux top(1)
- Página del manual de Linux ps(1)
- Página del manual de systemd systemctl(1)
Fecha de verificación de la información: 2026-11-03.