
CPUスパイク発生時に最初に行うべきこと:バースト、持続負荷、パネル制限の見極め#
VPSにログインして突然のCPU急上昇に気づいた場合でも、早まってサーバーを再起動したり、プランのアップグレードにお金を費やしたりするのは避けてください。最初のステップは常にワークロードの正確な性質を突き止めることです。数分ごとに発生する断続的なバーストなのか、それともアプリケーションの深刻なバックログに起因する持続的なキューなのかを判断します。
公式利用規約によると、BandwagonHostはnon-SLAプランにおいて短時間のCPUバーストと一時間の平均CPU許容量を区別しており、具体的な制限はプランの完全な名称によって決まります。これは、CPU使用率が一時的に100%に達しても、本質的に規約違反を構成するわけではないことを意味します。一時間の平均消費量がプランの割り当てを一貫して超過した場合にのみ、基盤となるハイパーバイザーが利用可能なCPUサイクルを制限します。制限中もVPSは稼働し続け、KiwiVMコントロールパネルにアラートが表示されます。平均使用率が許容制限内に戻ると、CPU制限は自動的に解除されます。公式規約は、制限が即座に、または設定された分数以内に解除されることを保証しておらず、CPU使用率のピークを示す単一のスナップショットをポリシー適用の証拠として扱うべきでもありません。
同時に、実際のアプリケーションパフォーマンスも観察してください。WebサイトやAPIの応答が完全に保たれ、タイムアウトのキューが発生せずにページが読み込まれ、KiwiVMダッシュボードにCPU警告が表示されていない場合、一時的なスパイクが訪問者の体験に与える影響は概して最小限です。
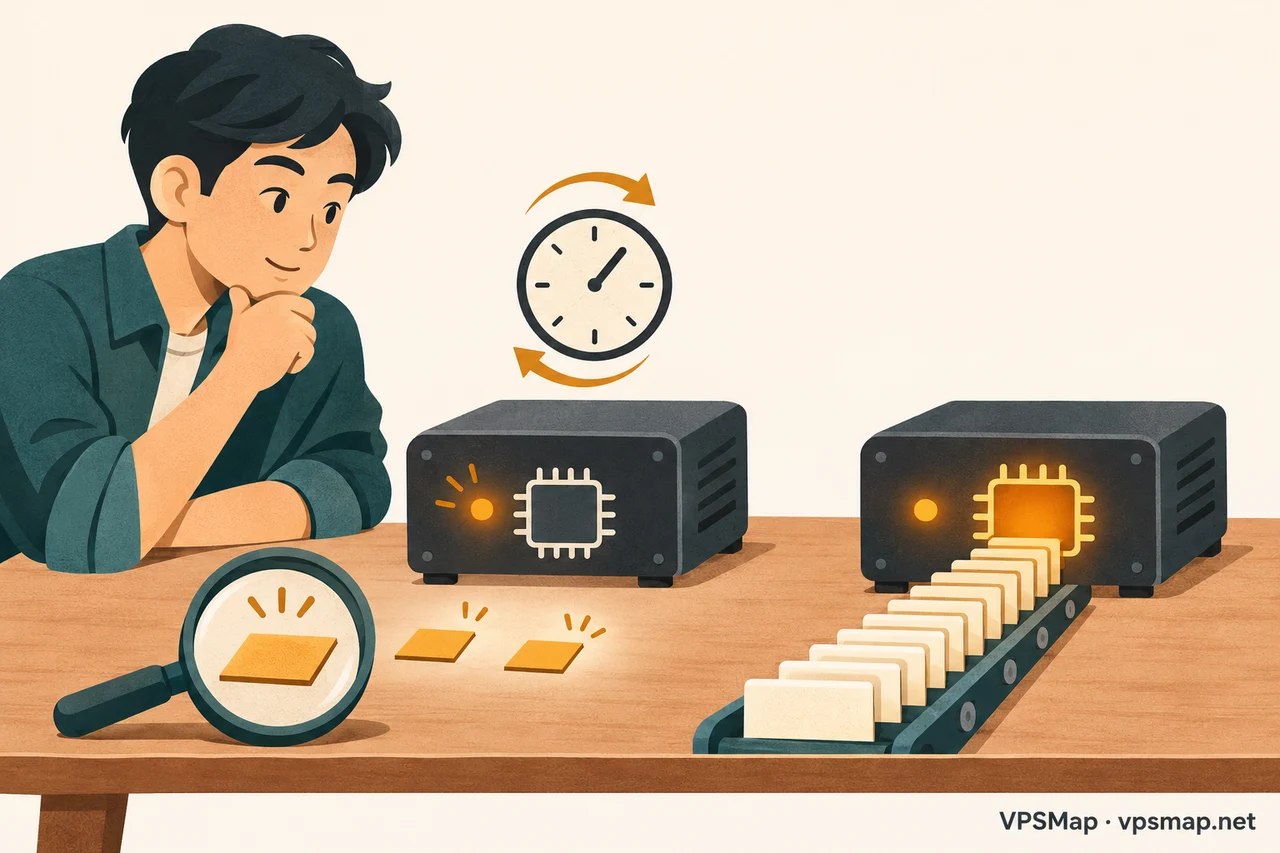
これらのシナリオの違いを理解することで、不要なインフラ費用を回避するのに役立ちます:
- 短時間の繰り返されるスパイク:CPUが一定の間隔で数秒間一時的に急上昇した後に素早く元に戻り、通常のトラフィックを処理しながらシステムはおおむねアイドル状態を維持します。
- 持続的な過負荷キュー:CPUが高負荷状態を維持し、一時間の平均消費量がプランのしきい値を超え、パネルの警告が作動して、一般ユーザーからのリクエストに遅延が発生します。
読み取り専用のLinuxツールを用いた継続的な観察とPIDの取得#
調査が必要と判断された場合は、システムの構成や実行中のサービスを一切変更することなく、安全な読み取り専用ツールを使用してオペレーティングシステム内部の診断データを収集します。
まずはバッチモードのtopを使用して、短時間の観察ウィンドウから始めます:
top -b -d 2 -n 6このコマンドは2秒間隔で6回の反復出力を取得し、最初の出力を遅延なく即座に生成します。この短い観測時間により、PID、COMMAND、%CPU、および実行のリズムを監視できます。短時間で終了するプロセスや断続的なプロセスはサンプリング間隔の合間に出現して終了する可能性がある点に注意してください。単一のサンプルでアクティビティを捉えられなかったからといって、その存在が否定されるわけではありません。このコマンドはprocpsを備えたLinux環境に適用されます。ツールが存在しない場合は、ディストリビューションのパッケージドキュメントを参照してください。
プロセステーブルの全体的なスナップショットを取得するには、psを使用してソートされたリストの先頭数行を確認します:
ps -eo pid,ppid,comm,pcpu,pmem --sort=-pcpu | head -n 16head -n 16にはテーブルヘッダーが含まれるため、出力の上位行が表示されます。正確なレポート指標に注意してください。ps内の%CPU(またはpcpu)は、プロセスの累積実行時間全体に対する生涯CPU時間の比率を表します。これは2秒のリアルタイムな瞬間サンプルでも、プロバイダーの一時間の請求指標でもありません。pcpuでソートすると、プロセスは瞬間的なリアルタイムピークではなく、生涯平均比率の順に並べ替えられます。commを使用すると、完全なコマンドライン引数なしで実行可能ファイルの名前が表示され、機密トークンや認証情報の露出を減らせますが、共有する前に出力をサニタイズする必要があります。
候補となるPIDを特定したら、これら二つのクエリを使用して実行継続時間と親プロセスの詳細を調査します:
ps -p PID -o pid,ppid,comm,etimes,pcpu,pmemps -p PARENT_PID -o pid,ppid,commプレースホルダーPIDおよびPARENT_PIDは、実際に確認された数値に必ず置き換えてください。短命なプロセスはすぐに終了する可能性があり、LinuxはPIDの値を再利用するため、調査前にプロセスがまだ実行中であることを確認してください。実行可能ファイル名だけでは、ソフトウェアの出所、正当性、あるいは安全に停止できるかどうかを証明することはできません。実行継続時間と親プロセスの系統を把握することが、正確なトラブルシューティングの基礎となります。
システムタイマーの関連付けとプロセスの発生源の追跡#
プロセスのアクティビティが厳密に繰り返されるスケジュールに従っている場合は、確認されたスパイクのタイムスタンプをシステムのスケジューリングメカニズムと関連付けて照合します。
systemdを採用しているシステムでは、次のコマンドを使用してタイマーユニットを検査します:
systemctl list-timers --all --no-pagerこれにより、systemdのメモリに現在読み込まれているすべてのタイマーユニット(非アクティブなユニットを含む)が、前回トリガーされた時間、次回スケジュールされた実行時間、および関連するサービスとともに一覧表示されます。これらのスケジュールをCPUスパイクのタイムスタンプと比較してください。なお、このコマンドはsystemd環境にのみ適用され、通常のcronジョブ、コンテナ内部のスケジュール、アプリケーションレベルの実行ループは表示されません。一致するタイマーが存在しないからといって、定期的なバックグラウンドタスクが存在しないことが保証されるわけではありません。さらに、トリガー時間が一致していても、それは診断の手がかりにすぎず、直接の因果関係を示す確実な証拠ではありません。
公開されている事例報告に関して、ユーザーのWilliam Long氏が2026-11-01にX上で、特定の環境において毎分繰り返される短いCPUスパイクについて投稿しました。これはプロバイダーによる公式な確認ではなく個別のユーザー報告であり、すべての運用環境に一般化すべきではありません。
特定されたタスクをその出所に基づいて処理します:
- ユーザーアプリケーションのワークロード:スパイクがデータベースのエクスポート、キャッシュの再構築、ログのメンテナンスなど確認済みの業務タスクに起因する場合は、同時実行数の調整、ワーカーキューの導入、またはトラフィックの少ないメンテナンス時間帯へのジョブの移動によって実行を最適化します。
- 見慣れないシステムコンポーネント:見慣れないプロセスやプリインストールされた管理デーモンに遭遇した場合、検証されていないオンラインの推奨事項に基づいてプロセスを強制終了したりサービスを無効化したりしないでください。仮想化管理チャネルが破損する恐れがあります。代わりに、診断ログを収集して公式の案内を求めてください。
既存のワークロードを最適化すべき時期とプランのアップグレードを検討すべき時期#
サーバー層のアップグレードを、未検証のバックグラウンドプロセスを覆い隠すために使用すべきではありません。根本的なソフトウェアループや設定に誤りのあるサービスがスパイクの原因である場合、より上位のプランに移行しても、より高額なマシンで計算リソースを消費するだけで問題は未解決のまま残ります。
プランのアップグレードが正当化されるのは、検証済みの本番ワークロードがハードウェアの割り当てと持続的な一時間のCPU許容量を一貫して超過する場合に限られます。BandwagonHostの異なるプラン層はそれぞれ個別のネットワーク転送オプションとデータセンター地域に重点を置いており、プレミアムネットワーク層を選択しても計算処理のスパイクは解決しません。
以下の確認済みプラン詳細をご確認ください:
| プラン名 | ハードウェア仕様 | ポート速度とトランジットプロファイル | 全期間参考価格 | 確認済み購入リンク |
|---|---|---|---|---|
| Basic 40G / 2GB (PID 45) | 3 vCPU / 2048 MB RAM / 40 GB ストレージ / 月間帯域幅 2000 GB | ポート速度 1000 Mbps、データセンター例:USCA_2 | 年額 $99.99(最短サイクルは半年ごとの $52.99) | Basic 40G を年払いで注文 |
| E-Commerce 40G / 2GB (PID 88) | 3 vCPU / 2048 MB RAM / 40 GB ストレージ / 月間帯域幅 2000 GB | ポート速度 2500 Mbps、データセンター例:USCA_9 | 年額 $299.99(最短サイクルは四半期ごとの $89.99) | E-Commerce 40G を年払いで注文 |
これらの選択肢を評価する際は、E-Commerce の価格設定が異常プロセスの緩和策ではなく、特定の対象層への接続性のために設計された専用のトランジットルートを反映したものである点をご認識ください。ポート速度は仮想インターフェースの能力を示しており、保証された継続的なトランジット帯域幅ではありません。年額請求のオプションは毎月の引き落としではなく全期間の一括前払いが必要です。利用可能な請求サイクルおよび在庫は2026-11-03に確認された状況を反映したものであり、チェックアウト時のリアルタイムな在庫状況に左右されます。
その他の有効な層やグローバル利用規約を確認するには、BandwagonHost メインポータルにアクセスするか、BandwagonHost プランカタログをご確認ください。
サポート問い合わせに向けた簡潔な診断記録の準備#
BandwagonHost はセルフマネージド型の KVM VPS ホスティングを運用しています。プロバイダーは物理ノードの健全性とネットワーク接続を管理しますが、オペレーティングシステムのメンテナンス、デーモンの設定、およびデータのバックアップは引き続きユーザーの責任となります。したがって、公式サポートへの問い合わせには、明確かつ簡潔で、読み取り専用の事実を提供する必要があります。
見慣れないプロセスがオペレーティングシステムのテンプレートに関連していると疑われる場合は、公式サポートチャネルからサポートに連絡する前に、最小限の診断ログをまとめてください:
- タイムスタンプとタイムゾーン:明確なタイムゾーン表記(UTCやローカルオフセットなど)を添えて、スパイクの正確なタイムスタンプを記録します。
- 本番環境への影響:発生中にユーザー向けウェブサービスやAPIで速度低下や接続失敗が発生したかどうかを明記します。
- スパイクの特徴:バーストの継続時間(秒単位)、再発頻度、および KiwiVM ダッシュボードで CPU スロットリングが表示されたかどうかを詳細に記述します。
- プロセスの出力フィールド:読み取り専用コマンドで収集した PID、親 PID、実行可能ファイル名(comm)、および実行継続時間を添付します。
- 環境の詳細:Linux ディストリビューション、カーネルリリース、およびデータセンターのロケーションコードを記載します。
送信する前に、徹底したプライバシー監査を実施してください:すべての秘密鍵、パスワード、APIトークン、機密情報を含む完全なコマンドライン、顧客レコード、および請求データを削除します。問い合わせは、そのコンポーネントの所定の機能、該当するテンプレートのバージョン、および推奨されるメンテナンス手順の明確化に集中させてください。サポートチームは特定の対応時間や事前定義された解決策を確約しません。
その他のセットアップおよびコントロールパネルのリファレンスについては、BandwagonHost 概要およびKiwiVM API ガイドを参照してください。
公式ドキュメントおよび参考資料:
- BandwagonHost 利用規約
- BandwagonHost 製品カタログ
- Linux top(1) マニュアルページ
- Linux ps(1) マニュアルページ
- systemd systemctl(1) マニュアルページ
情報確認日:2026-11-03。