
Erste Schritte bei CPU-Spitzen: Unterscheidung von Bursts, anhaltender Last und Panel-Grenzwerten#
Wenn Sie sich auf Ihrem VPS anmelden und einen plötzlichen CPU-Anstieg feststellen, sollten Sie es vermeiden, voreilig den Server neu zu starten oder Geld für Plan-Upgrades auszugeben. Ihr erster Schritt sollte immer darin bestehen, die genaue Art der Arbeitslast zu bestimmen: Handelt es sich um einen intermittierenden Burst, der alle paar Minuten auftritt, oder um eine anhaltende Warteschlange, die durch einen hohen Anwendungsrückstau verursacht wird?
Gemäß den offiziellen Nutzungsbedingungen unterscheidet BandwagonHost bei Nicht-SLA-Plänen zwischen kurzfristigen CPU-Bursts und dem einstündigen durchschnittlichen CPU-Kontingent, wobei die genauen Grenzen durch den vollständigen Plannamen bestimmt werden. Das bedeutet, dass das kurzzeitige Erreichen einer CPU-Auslastung von 100% für sich genommen keinen Richtlinienverstoß darstellt. Erst wenn der einstündige Durchschnittsverbrauch Ihr Plankontingent dauerhaft übersteigt, drosselt der zugrunde liegende Hypervisor die verfügbaren CPU-Zyklen. Während der Drosselung bleibt Ihr VPS weiter in Betrieb, und im KiwiVM-Control-Panel erscheint eine Warnmeldung; sobald die durchschnittliche Auslastung wieder innerhalb der zulässigen Grenzen liegt, werden die CPU-Einschränkungen automatisch aufgehoben. Die offiziellen Bedingungen garantieren nicht, dass Beschränkungen sofort oder innerhalb einer festgelegten Anzahl von Minuten aufgehoben werden, noch sollte eine einzelne Momentaufnahme voller CPU-Auslastung als Beweis für eine Richtliniendurchsetzung gewertet werden.
Beobachten Sie gleichzeitig die tatsächliche Anwendungsleistung. Wenn Ihre Websites und API-Antworten weiterhin vollständig reagieren, Seiten ohne Timeout-Warteschlangen geladen werden und das KiwiVM-Dashboard keine CPU-Warnungen anzeigt, haben kurze Spitzen im Allgemeinen minimale Auswirkungen auf das Besuchererlebnis.
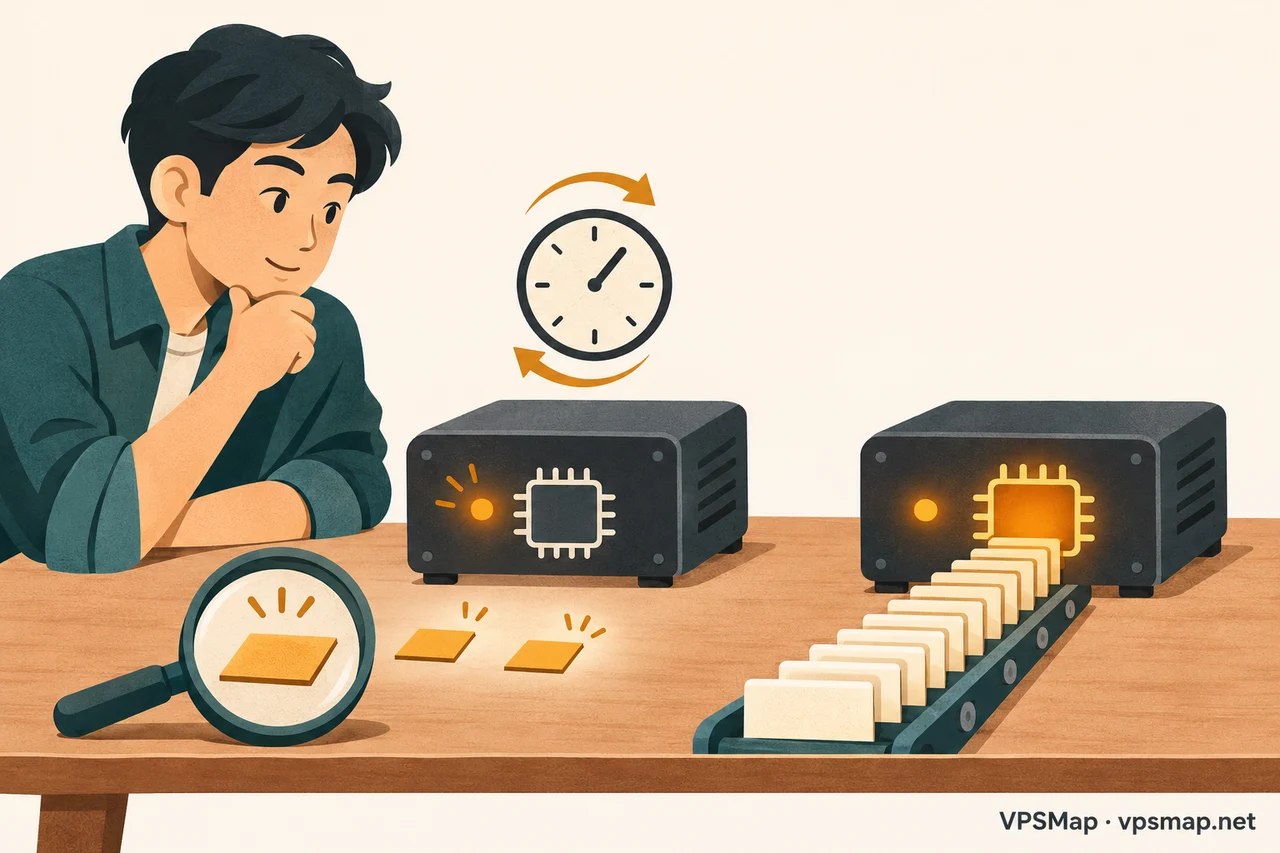
Das Verständnis der Unterschiede zwischen diesen Szenarien hilft, unnötige Infrastrukturausgaben zu vermeiden:
- Kurze wiederholte Spitzen: Die CPU steigt in regelmäßigen Abständen für einige Sekunden kurz an, bevor sie schnell wieder abfällt, sodass das System bei normaler Bereitstellung des Datenverkehrs weitgehend im Leerlauf bleibt.
- Anhaltende Überlastungswarteschlangen: Die CPU bleibt durchgehend stark ausgelastet, der Durchschnittsverbrauch über eine Stunde überschreitet die Plankontingente, Panel-Warnungen werden aktiviert und öffentliche Anfragen verzögern sich.
Kontinuierliche Beobachtung und Erfassung von PIDs mit schreibgeschützten Linux-Tools#
Sobald eine Untersuchung als notwendig erachtet wird, sollten Sie Diagnosedaten innerhalb des Betriebssystems mithilfe sicherer, schreibgeschützter Tools erfassen, ohne jegliche Systemkonfigurationen oder ausgeführte Dienste zu ändern.
Beginnen Sie mit einem kurzen Beobachtungszeitraum unter Verwendung von top im Batch-Modus:
top -b -d 2 -n 6Dieser Befehl erfasst 6 Iterationen in Intervallen von 2 Sekunden und erzeugt die erste Ausgabe sofort ohne anfängliche Verzögerung. Dieses kurze Zeitfenster ermöglicht es Ihnen, PID, COMMAND, %CPU und den Ausführungsrhythmus zu überwachen. Beachten Sie, dass kurzlebige oder intermittierende Prozesse zwischen den Abtastintervallen auftreten und wieder beendet werden können; das Ausbleiben von Aktivitäten in einer Stichprobe schließt deren Existenz nicht aus. Dieser Befehl gilt für Linux-Umgebungen, die mit procps ausgestattet sind; konsultieren Sie die Paketdokumentation Ihrer Distribution, falls das Tool nicht vorhanden ist.
Um eine umfassende Momentaufnahme der Prozesstabelle zu erfassen, verwenden Sie ps, um die ersten Zeilen der sortierten Liste zu überprüfen:
ps -eo pid,ppid,comm,pcpu,pmem --sort=-pcpu | head -n 16Da head -n 16 die Tabellenüberschrift enthält, werden die obersten Zeilen der Ausgabe angezeigt. Beachten Sie die genaue Berichtsmetrik: %CPU (oder pcpu) in ps stellt das Verhältnis der gesamten CPU-Zeit über die Lebensdauer zur gesamten verstrichenen Prozesslaufzeit dar. Es handelt sich weder um eine 2-sekündige Echtzeit-Momentaufnahme noch um die einstündige Abrechnungsmetrik des Anbieters. Die Sortierung nach pcpu ordnet Prozesse nach ihrem durchschnittlichen Verhältnis über die gesamte Lebensdauer und nicht nach kurzzeitigen Echtzeitspitzen. Die Verwendung von comm zeigt ausführbare Namen ohne vollständige Befehlszeilenargumente an, was die Offenlegung vertraulicher Token oder Anmeldeinformationen reduziert, wenngleich Ausgaben vor der Weitergabe dennoch bereinigt werden müssen.
Nachdem Sie eine infrage kommende PID identifiziert haben, prüfen Sie deren Laufzeitdauer und die Details des übergeordneten Prozesses anhand dieser zwei Abfragen:
ps -p PID -o pid,ppid,comm,etimes,pcpu,pmemps -p PARENT_PID -o pid,ppid,commErsetzen Sie die Platzhalter PID und PARENT_PID immer durch tatsächlich beobachtete numerische Werte. Kurzlebige Prozesse können schnell beendet werden, und Linux verwendet PID-Werte wieder; stellen Sie daher vor der Überprüfung sicher, dass der Prozess noch läuft. Ein ausführbarer Name allein beweist weder die Herkunft der Software noch deren Legitimität oder ob sie sicher gestoppt werden kann; die Erfassung der Laufzeitdauer und der übergeordneten Prozessabstammung bildet die Grundlage für eine präzise Fehlerbehebung.
Korrelieren von System-Timern und Nachverfolgen von Prozessursprüngen#
Wenn die Prozessaktivität einem strikt wiederkehrenden Zeitplan folgt, sollten Sie die beobachteten Zeitstempel der Spitzenwerte mit den Planungsmechanismen des Systems abgleichen.
Auf Systemen, die systemd nutzen, überprüfen Sie die Timer-Units mit folgendem Befehl:
systemctl list-timers --all --no-pagerDadurch werden alle derzeit in den systemd-Speicher geladenen Timer-Units (einschließlich inaktiver Units) zusammen mit ihrer letzten Auslösezeit, dem nächsten geplanten Durchlauf und dem zugehörigen Dienst aufgelistet. Vergleichen Sie diese Zeitpläne mit den Zeitstempeln Ihrer CPU-Spitzen. Beachten Sie, dass dieser Befehl nur für systemd-Umgebungen gilt und weder standardmäßige Cron-Jobs noch containerinterne Zeitpläne oder Ausführungsschleifen auf Anwendungsebene anzeigt; das Fehlen passender Timer garantiert nicht, dass keine periodische Hintergrundaufgabe existiert. Darüber hinaus liefern identische Auslösezeiten lediglich diagnostische Hinweise und keinen endgültigen Beweis für einen Kausalzusammenhang.
Was öffentliche Fallberichte betrifft, so veröffentlichte der Benutzer William Long am 2026-11-01 auf X einen Beitrag, in dem er kurze CPU-Spitzen beschrieb, die in einer bestimmten Umgebung minütlich wiederkehrten. Dies stellt einen isolierten Bericht eines einzelnen Benutzers dar und keine offizielle Bestätigung des Anbieters, weshalb er nicht auf alle Betriebsumgebungen verallgemeinert werden sollte.
Behandeln Sie identifizierte Aufgaben basierend auf deren Ursprung:
- Workloads von Benutzeranwendungen: Wenn Spitzen von bestätigten geschäftlichen Aufgaben wie Datenbankexporten, Cache-Neuerstellungen oder Protokollwartungen herrühren, optimieren Sie die Ausführung, indem Sie die Parallelität anpassen, Worker-Queues implementieren oder Aufgaben in wartungsarme Zeitfenster mit geringem Datenverkehr verschieben.
- Unbekannte Systemkomponenten: Wenn Sie auf einen unbekannten Prozess oder einen vorinstallierten Verwaltungs-Daemon stoßen, beenden Sie niemals Prozesse oder deaktivieren Sie Dienste auf der Grundlage ungeprüfter Online-Empfehlungen, da dies die Virtualisierungs-Verwaltungskanäle beschädigen kann. Erfassen Sie stattdessen Diagnoseprotokolle und bitten Sie um offizielle Unterstützung.
Wann bestehende Workloads optimiert werden sollten vs. Wann Tarif-Upgrades in Betracht zu ziehen sind#
Ein Upgrade von Server-Tarifstufen sollte niemals dazu verwendet werden, ungeprüfte Hintergrundprozesse zu verschleiern. Wenn eine zugrunde liegende Softwareschleife oder ein fehlkonfigurierter Dienst die Spitzen verursacht, führt der Wechsel zu einem größeren Tarif lediglich dazu, dass Rechenleistung auf einer teureren Maschine verbraucht wird, während das Problem ungelöst bleibt.
Tarif-Upgrades sind nur dann gerechtfertigt, wenn Ihre verifizierten Produktions-Workloads die Hardware-Zuteilungen und die anhaltende einstündige CPU-Zulage dauerhaft überschreiten. Verschiedene Tarifstufen von BandwagonHost konzentrieren sich auf unterschiedliche Netzwerk-Transit-Optionen und Rechenzentrumsregionen; die Wahl einer Premium-Netzwerkstufe behebt keine Rechenspitzen.
Prüfen Sie die folgenden verifizierten Tarifdetails:
| Tarifname | Hardware-Spezifikationen | Port-Geschwindigkeit und Transit-Profil | Referenzpreis für die Gesamtlaufzeit | Verifizierter Kauf-Link |
|---|---|---|---|---|
| Basic 40G / 2GB (PID 45) | 3 vCPU / 2048 MB RAM / 40 GB Speicher / 2000 GB monatliche Bandbreite | 1000 Mbps Port-Geschwindigkeit, Beispiel-Rechenzentrum USCA_2 | $99.99 jährlich (kürzester Zyklus halbjährlich zu $52.99) | Basic 40G jährlich bestellen |
| E-Commerce 40G / 2GB (PID 88) | 3 vCPU / 2048 MB RAM / 40 GB Speicher / 2000 GB monatliche Bandbreite | 2500 Mbps Port-Geschwindigkeit, Beispiel-Rechenzentrum USCA_9 | $299.99 jährlich (kürzester Zyklus vierteljährlich zu $89.99) | E-Commerce 40G jährlich bestellen |
Beachten Sie bei der Bewertung dieser Optionen, dass die E-Commerce-Preise spezialisierte Transit-Routen widerspiegeln, die für die Konnektivität mit bestimmten Zielgruppen ausgelegt sind, und keine Maßnahme zur Behebung anomaler Prozesse darstellen. Port-Geschwindigkeiten stellen die Kapazitäten virtueller Schnittstellen dar, keine garantierte kontinuierliche Transit-Bandbreite. Jährliche Abrechnungsoptionen erfordern eine Vorauszahlung für die gesamte Laufzeit anstelle monatlicher Abbuchungen. Verfügbare Abrechnungszyklen und Bestände spiegeln die am 2026-11-03 beobachteten Bedingungen wider und hängen von der Verfügbarkeit beim Bezahlvorgang in Echtzeit ab.
Um weitere aktive Tarifstufen und globale Bedingungen zu erkunden, besuchen Sie das BandwagonHost-Hauptportal oder prüfen Sie den BandwagonHost-Tarifkatalog.
Vorbereitung eines prägnanten Diagnoseprotokolls für Support-Anfragen#
BandwagonHost betreibt selbstverwaltetes KVM-VPS-Hosting. Der Anbieter verwaltet den Zustand der physischen Knoten und die Netzwerkkonnektivität, während die Betriebssystemwartung, die Daemon-Konfiguration und Datensicherungen in der Verantwortung des Benutzers verbleiben. Folglich muss jede Anfrage an den offiziellen Support klare, prägnante und schreibgeschützte Fakten liefern.
Wenn Sie vermuten, dass ein unbekannter Prozess mit einer Betriebssystemvorlage zusammenhängt, erstellen Sie ein minimales Diagnoseprotokoll, bevor Sie den Support über Offizielle Support-Kanäle kontaktieren:
- Zeitstempel und Zeitzone: Notieren Sie genaue Spitzen-Zeitstempel mit expliziter Zeitzonenangabe (wie UTC oder lokale Zeitverschiebung).
- Auswirkungen auf die Produktion: Geben Sie an, ob bei Webdiensten oder APIs mit Benutzerzugriff während des Vorfalls Verlangsamungen oder Verbindungsfehler aufgetreten sind.
- Spitzenmerkmale: Detaillieren Sie die Burst-Dauer in Sekunden, die Wiederholungshäufigkeit und ob das KiwiVM-Dashboard eine CPU-Drosselung anzeigte.
- Prozessausgabefelder: Fügen Sie die über schreibgeschützte Befehle erfasste PID, übergeordnete PID, den Namen der ausführbaren Datei (comm) und die Laufzeitdauer an.
- Umgebungsdetails: Listen Sie die Linux-Distribution, den Kernel-Release und den Standortcode des Rechenzentrums auf.
Führen Sie vor dem Absenden eine gründliche Datenschutzprüfung durch: Entfernen Sie alle privaten Schlüssel, Passwörter, API-Token, vollständige Befehlszeilen mit Geheimnissen, Kundendatensätze und Abrechnungsdaten. Konzentrieren Sie die Anfrage auf die Klärung der vorgesehenen Funktion der Komponente, der zutreffenden Vorlagenversionen und der empfohlenen Wartungsverfahren. Die Support-Teams verpflichten sich nicht zu bestimmten Bearbeitungszeiten oder vordefinierten Lösungen.
Weitere Referenzen zur Einrichtung und zum Control Panel finden Sie in der BandwagonHost-Übersicht und im KiwiVM-API-Leitfaden.
Offizielle Dokumentation und Referenzen:
- BandwagonHost Allgemeine Geschäftsbedingungen
- BandwagonHost-Produktkatalog
- Linux top(1) Handbuchseite
- Linux ps(1) Handbuchseite
- systemd systemctl(1) Handbuchseite
Datum der Informationsprüfung: 2026-11-03.