
Cosa fare per prima cosa durante i picchi di CPU: distinguere tra picchi temporanei, carico prolungato e limiti del pannello#
Quando si accede al proprio VPS e si nota un improvviso picco di CPU, è bene evitare di precipitarsi a riavviare il server o a spendere denaro per aggiornare il piano. Il primo passo dovrebbe sempre consistere nel determinare l'esatta natura del carico di lavoro: si tratta di un picco intermittente che si ripete ogni pochi minuti o di una coda prolungata causata da un consistente accumulo di richieste dell'applicazione?
In base ai Termini di Servizio ufficiali, BandwagonHost separa i picchi temporanei di CPU dalla quota media di CPU su base oraria per i piani non-SLA, con limiti specifici stabiliti dal nome completo del piano. Ciò significa che raggiungere brevemente un utilizzo della CPU pari a 100% non costituisce di per sé una violazione delle condizioni d'uso. Solo quando il consumo medio di un'ora supera costantemente la quota del piano, l'hypervisor sottostante ridurrà i cicli di CPU disponibili. Durante la limitazione, il VPS continua a funzionare e compare un avviso nel pannello di controllo KiwiVM; non appena l'utilizzo medio rientra nei limiti consentiti, le restrizioni sulla CPU vengono revocate automaticamente. I termini ufficiali non garantiscono che i limiti vengano rimossi istantaneamente o entro un numero prestabilito di minuti, né una singola rilevazione del pieno utilizzo della CPU deve essere considerata una prova dell'applicazione delle restrizioni.
Contemporaneamente, è opportuno osservare le prestazioni reali delle applicazioni. Se i siti web e le risposte delle API restano pienamente reattivi, le pagine si caricano senza code di timeout e la dashboard di KiwiVM non mostra avvisi sulla CPU, i brevi picchi hanno generalmente un impatto minimo sull'esperienza dei visitatori.
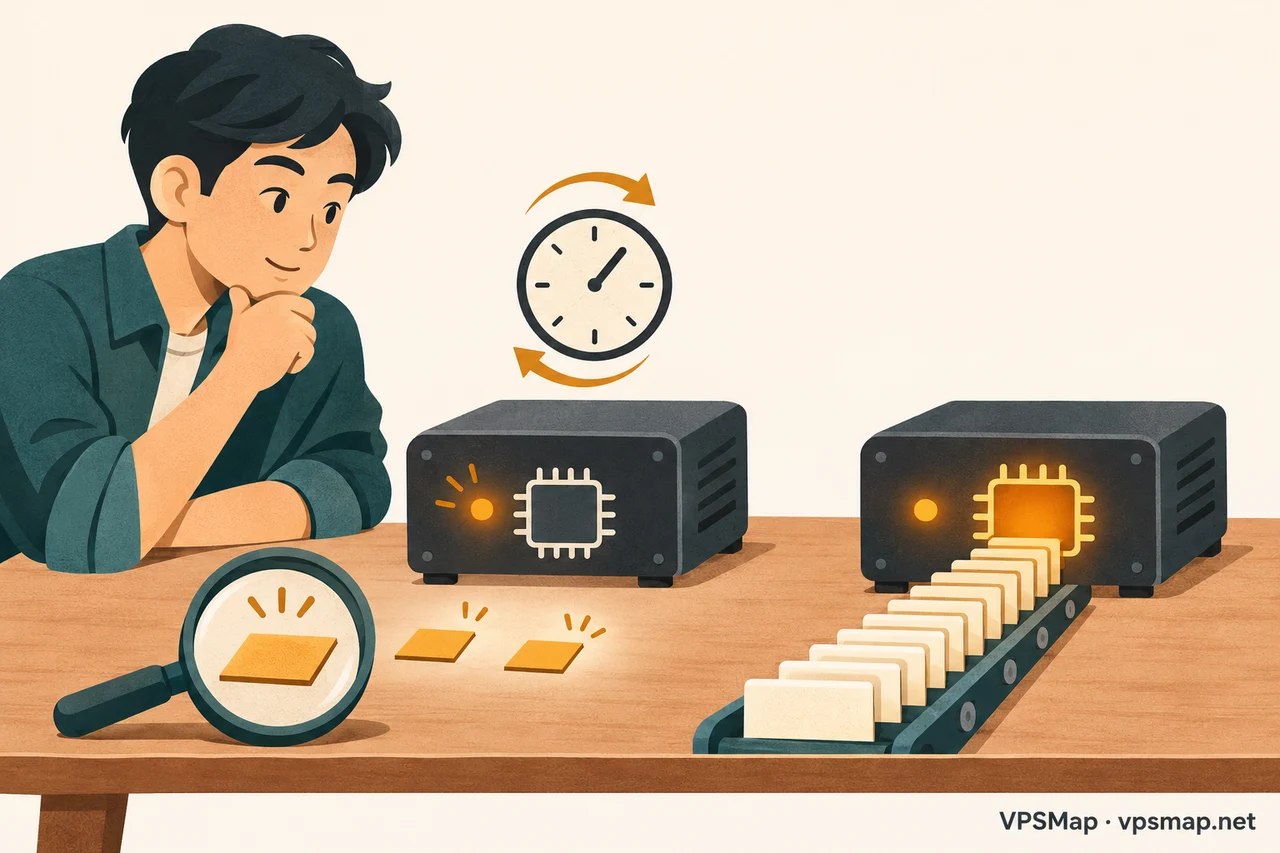
Comprendere la differenza tra questi scenari aiuta a evitare spese infrastrutturali non necessarie:
- Brevi picchi ripetuti: la CPU aumenta brevemente per alcuni secondi a intervalli regolari prima di tornare subito a livelli bassi, lasciando il sistema prevalentemente inattivo con una normale gestione del traffico.
- Code di sovraccarico prolungato: la CPU rimane costantemente elevata, il consumo medio nell'arco di un'ora supera le soglie del piano, si attivano gli avvisi del pannello e le richieste pubbliche subiscono rallentamenti.
Osservazione continua e acquisizione dei PID con strumenti Linux di sola lettura#
Quando un'indagine è ritenuta necessaria, raccogliete i dati di diagnostica all'interno del sistema operativo utilizzando strumenti sicuri e di sola lettura, senza modificare le configurazioni di sistema o i servizi in esecuzione.
Iniziate con una breve finestra di osservazione utilizzando top in modalità batch:
top -b -d 2 -n 6Questo comando acquisisce 6 iterazioni a intervalli di 2 secondi, producendo il primo output immediatamente senza ritardi iniziali. Questa breve finestra temporale consente di monitorare PID, COMMAND, %CPU e il ritmo di esecuzione. Si tenga presente che i processi di breve durata o intermittenti possono avviarsi e terminare tra un intervallo di campionamento e l'altro; non rilevare attività in un singolo campionamento non ne esclude l'esistenza. Questo comando è utilizzabile in ambienti Linux dotati di procps; consultare la documentazione dei pacchetti della distribuzione qualora lo strumento non sia presente.
Per acquisire una panoramica generale della tabella dei processi, utilizzare ps per esaminare le prime righe dell'elenco ordinato:
ps -eo pid,ppid,comm,pcpu,pmem --sort=-pcpu | head -n 16Poiché head -n 16 include l'intestazione della tabella, mostra le prime righe dell'output. Si noti la metrica di misurazione esatta: %CPU (o pcpu) in ps rappresenta il rapporto tra il tempo di CPU consumato nel ciclo di vita e il tempo di esecuzione totale trascorso del processo. Non si tratta né di un campionamento istantaneo in tempo reale di 2 secondi né della metrica di fatturazione oraria del provider. L'ordinamento in base a pcpu ordina i processi in base alla media dell'intero ciclo di vita anziché ai picchi momentanei in tempo reale. L'uso di comm mostra i nomi degli eseguibili senza gli argomenti completi della riga di comando, riducendo l'esposizione di token o credenziali riservate, sebbene gli output debbano comunque essere sanificati prima della condivisione.
Dopo aver identificato un PID candidato, esaminare la durata di esecuzione e i dettagli del processo genitore utilizzando queste due query:
ps -p PID -o pid,ppid,comm,etimes,pcpu,pmemps -p PARENT_PID -o pid,ppid,commSostituire sempre i segnaposto PID e PARENT_PID con i valori numerici effettivamente rilevati. I processi temporanei possono terminare rapidamente e Linux riutilizza i valori PID, pertanto è necessario verificare che il processo sia ancora in esecuzione prima dell'ispezione. Il solo nome dell'eseguibile non dimostra la provenienza del software, la sua legittimità o la possibilità di arrestarlo in sicurezza; acquisire la durata dell'esecuzione e la gerarchia del processo padre fornisce le basi per una risoluzione accurata dei problemi.
Correlazione dei timer di sistema e tracciamento delle origini dei processi#
Quando l'attività di un processo segue una pianificazione rigorosamente ripetuta, è opportuno correlare i timestamp dei picchi osservati con i meccanismi di pianificazione del sistema.
Sui sistemi che utilizzano systemd, esaminare le unità timer con il seguente comando:
systemctl list-timers --all --no-pagerQuesto elenca tutte le unità timer attualmente caricate nella memoria di systemd (comprese le unità inattive), insieme all'orario dell'ultima attivazione, alla successiva esecuzione pianificata e al servizio associato. Confrontate queste pianificazioni con i timestamp dei vostri picchi di CPU. Si noti che questo comando si applica solo agli ambienti systemd e non mostra i consueti processi cron, le pianificazioni interne ai container o i cicli di esecuzione a livello di applicazione; l'assenza di timer corrispondenti non garantisce che non esista alcun processo periodico in background. Inoltre, orari di attivazione identici forniscono indizi diagnostici piuttosto che una prova definitiva di causalità.
Per quanto riguarda le segnalazioni pubbliche di casi, l'utente William Long ha pubblicato su X in data 2026-11-01 la descrizione di brevi picchi di CPU ricorrenti ogni minuto in un ambiente specifico. Ciò rappresenta la segnalazione isolata di un singolo utente anziché una conferma ufficiale da parte del provider, e non dovrebbe essere generalizzata a tutte le configurazioni operative.
Gestisci le attività identificate in base alla loro origine:
- Carichi di lavoro delle applicazioni utente: se i picchi derivano da attività aziendali confermate come esportazioni di database, ricostruzioni della cache o manutenzione dei log, ottimizza l'esecuzione regolando la concorrenza, implementando code di worker o spostando i job in finestre di manutenzione a basso traffico.
- Componenti di sistema sconosciuti: se riscontri un processo sconosciuto o un daemon di gestione preinstallato, non terminare mai i processi né disabilitare i servizi in base a raccomandazioni online non verificate, poiché ciò potrebbe interrompere i canali di gestione della virtualizzazione. Raccogli invece i log di diagnostica e richiedi indicazioni ufficiali.
Quando ottimizzare i carichi di lavoro esistenti rispetto a considerare l'upgrade del piano#
L'upgrade dei livelli di server non dovrebbe mai essere utilizzato per mascherare processi in background non verificati. Se la causa dei picchi è un loop software sottostante o un servizio configurato in modo errato, il passaggio a un piano superiore si limiterà a consumare risorse di calcolo su una macchina più costosa, lasciando il problema irrisolto.
Gli upgrade di piano sono giustificati solo quando i tuoi carichi di lavoro di produzione verificati superano costantemente le allocazioni hardware e la tolleranza sostenuta di CPU di un'ora. I diversi livelli di piano BandwagonHost si concentrano su distinte opzioni di transito di rete e regioni di data center; la scelta di un livello di rete premium non risolve i picchi di calcolo.
Esamina i seguenti dettagli verificati del piano:
| Nome del piano | Specifiche hardware | Velocità della porta e profilo di transito | Prezzo di riferimento per l'intero periodo | Link di acquisto verificato |
|---|---|---|---|---|
| Basic 40G / 2GB (PID 45) | 3 vCPU / 2048 MB RAM / 40 GB di archiviazione / 2000 GB di larghezza di banda mensile | Velocità della porta di 1000 Mbps, data center di esempio USCA_2 | $99.99 all'anno (ciclo più breve semestrale a $52.99) | Ordina Basic 40G annualmente |
| E-Commerce 40G / 2GB (PID 88) | 3 vCPU / 2048 MB RAM / 40 GB di archiviazione / 2000 GB di larghezza di banda mensile | Velocità della porta di 2500 Mbps, data center di esempio USCA_9 | $299.99 all'anno (ciclo più breve trimestrale a $89.99) | Ordina E-Commerce 40G annualmente |
Nel valutare queste opzioni, tieni presente che i prezzi di E-Commerce riflettono percorsi di transito specializzati progettati per la connettività di un pubblico di riferimento, anziché una mitigazione per processi anomali. Le velocità della porta rappresentano capacità dell'interfaccia virtuale, non larghezza di banda di transito continuo garantita. Le opzioni di fatturazione annuale richiedono il pagamento anticipato per l'intero periodo anziché detrazioni mensili. I cicli di fatturazione e le disponibilità a magazzino riflettono le condizioni osservate il 2026-11-03 e dipendono dalla disponibilità in tempo reale al momento del checkout.
Per esplorare ulteriori livelli attivi e condizioni globali, visita il Portale principale di BandwagonHost o consulta il Catalogo dei piani BandwagonHost.
Preparazione di un report diagnostico conciso per le richieste di supporto#
BandwagonHost gestisce hosting KVM VPS self-managed. Il provider gestisce lo stato dei nodi fisici e la connettività di rete, mentre la manutenzione del sistema operativo, la configurazione dei daemon e i backup dei dati rimangono di responsabilità dell'utente. Di conseguenza, qualsiasi richiesta rivolta al supporto ufficiale deve fornire dati chiari, concisi e di sola lettura.
Se sospetti che un processo sconosciuto sia legato a un template del sistema operativo, crea un log di diagnostica essenziale prima di contattare l'assistenza tramite i Canali di supporto ufficiali:
- Timestamp e fuso orario: annota i timestamp esatti dei picchi con l'indicazione esplicita del fuso orario (come UTC o offset locale).
- Impatto sulla produzione: indica se i servizi web o le API rivolti agli utenti hanno subito rallentamenti o errori di connessione durante l'evento.
- Caratteristiche del picco: descrivi in dettaglio la durata del burst in secondi, la frequenza di ricorrenza e se la dashboard KiwiVM indicava il throttling della CPU.
- Campi di output del processo: allega PID, PID padre, nome dell'eseguibile (comm) e durata di esecuzione raccolti tramite comandi di sola lettura.
- Dettagli dell'ambiente: elenca la distribuzione Linux, la versione del kernel e il codice di posizione del data center.
Prima dell'invio, esegui un controllo approfondito della privacy: rimuovi tutte le chiavi private, le password, i token API, le righe di comando complete contenenti dati riservati, i record dei clienti e i dati di fatturazione. Focalizza la richiesta sul chiarimento della funzione prevista del componente, sulle versioni dei template applicabili e sulle procedure di manutenzione raccomandate. I team di supporto non si impegnano a garantire tempi di risposta specifici o soluzioni predefinite.
Per ulteriori riferimenti alla configurazione e al pannello di controllo, consulta la Panoramica di BandwagonHost e la Guida all'API KiwiVM.
Documentazione ufficiale e riferimenti:
- Termini di servizio di BandwagonHost
- Catalogo prodotti BandwagonHost
- Pagina del manuale di Linux top(1)
- Pagina del manuale di Linux ps(1)
- Pagina del manuale di systemd systemctl(1)
Data di verifica delle informazioni: 2026-11-03.